


Section2:
立体音響
Immersive Audio
2026.9.28 第二稿作業中
- 1 はじめにOverview
- 2 第1章:音サウンドの歴史The History of Audio sound
- 3 第1章:立体音響の基礎理論Spatial Audio Principles
- 4 第2章:3D空間における空間オーディオ設計Spatial Audio Design in 3D Space
- 5 第3章:ポストプロダクションとミキシングPost-Production & Mixing
- 6 第4章:音響ディスプレイと実空間インフラAuditory Display & Real Spaces
- 7 第5章:次世代イマーシブ音響と今後の展望Future of Acoustic Computing
- 8 終章:現場の開発者・未来の空間クリエイターへの提言
- 9 立体音響・イマーシブオーディオ 用語集(Glossary)
- 10 立体音響パート 参考文献(References)
はじめに
Overview
空間コンピューティング(Spatial Computing)の到来は、私たちの「視覚」にスクリーンというフレームを突き破る圧倒的な変革をもたらしました。しかし、どれほど高精細な3D立体映像が目の前に広がり、完璧な幾何学的視差(Parallax)がデザインされていても、そこを流れる「音」が従来の平坦な2Dステレオのままであったなら、人間の脳は一瞬にして現実に引き戻されてしまいます。
人間の空間認知において、
「視覚」と「聴覚」は、それぞれ異なる手がかりを用いながら、空間の位置や距離を統合的に知覚しています。3D立体映像が「目に見える空間のレイヤー」を拡張する技術であるならば、立体音響(イマーシブオーディオImmersive Audio)は、その空間を耳から包み込み、物質的な実在感と気配を脳に錯覚させるための「不可視の空間設計」です。
しかし、立体音響を制作・実装するためには、単にスピーカーの数を増やしたり、5.1chや7.1chといったレガシーな再生規格の枠組みに音を閉じ込めたりするだけでは不十分です。不適切な音響設計は、「映像と音のデプス(深度)の不一致」というバグを生み出し、視聴者に深刻な違和感や脳の疲労を誘発してしまいます。
本セクションではリスナーのインタラクションや環境要因に最適化された「立体音響(Immersive Audio)」の基本概念から最新の実装フォーマットまでを体系的に解説します。
立体音響セクションの目的と3つのアプローチ
本書の目的は、「クリエイター」「プロの音響エンジニア」「システム開発者」のすべてのレイヤーに共通の設計思想を提供し、音をチャンネルという物理的な制約から解き放ち、自由な「空間座標」へと配置設計・レンダリングするためのワークフローを確立することにあります。
- 【Design】クリエイターへ:音を「空間」として捉える思考のアップデート
単に音を左右に振る(パンニング)という2次元の思考を脱却し、リスナーを取り囲む「球体の空間(アンビソニックス)」や、ヘッドトラッキングと連動した「ピンポイントな定位感」を直感的にデザインできる基礎知識を養います。 - 【Technique】プロのエンジニアへ:映像と音の「デプスマッチング」と実空間制御
映像の3D配置(負・ゼロ・正のパララックス)に音の距離減衰や空気吸収を完璧に同期させる技術、およびオブジェクトベース音響(Dolby Atmos等)のミキシング論から、「d&b Soundscape」や「YAMAHA: Sound xR Image」を用いたリアルな物理空間(LBE・ライブステージ)への実装ワークフローを解説します。 - 【Engineering】システム開発者へ:生体工学に基づくレンダリング最適化
人間の頭部や耳介の形状をハッキングする「頭部伝達関数(HRTF)」や「SOFA規格」のシステム実装、ゲームエンジンやXRアプリにおける高負荷な「レイトレース方式(音線シミュレーション)」と低負荷な「特徴予測方式」を動的に切り替える最適化ロジックへの架け橋となります。
「立体音響(Immersive Audio)」を考えるうえでは、単に音の位置を再現するだけでなく、リスナーのインタラクションや再生環境、空間の特性などを考慮し、どのような聴覚体験を設計するかという視点が重要になります。一方、「空間音響(Spatial Audio)」は、音源の位置や音場、再生環境などの情報をもとに、リスナーの状態や環境に応じた音をリアルタイムなインタラクションデータからレンダリングする技術領域として捉えることができます。
つまり、立体音響は単に機材のスペックを競うものではなく、人間が音の方向・距離・空間をどのように知覚するのかを理解し、その知覚特性をデジタル信号処理によって設計する試みでもあります。
それは単に機材のスペックを語ることではなく、人間の耳と脳の知覚トリックをデジタル信号処理でハッキングし、そこに「確かな世界が実在する」と脳に認めさせる生体工学への挑戦です。
本書が、音響に対してのクリエイティビティを拡張するための確かな道標となることを願っています。
第1章:
音サウンドの歴史
The History of Audio sound
少しだけ、音=サウンドの進化と歴史について説明していきます。
音響技術の歴史はトーマス・エジソンが1877年に発明した蓄音機(Phonograph)にまで遡ります。大きなラッパに向かって声を発し、その振動を錫箔(のちに蝋管)の円筒に針で刻み込む仕組みです。その後、エミール・ベルリナーが、現代のレコードの原型となる「円盤型(ディスク)」の蓄音機を発明しました。これにより、音を大量に複製して流通させることが可能になりました。
第1章:
立体音響の基礎理論
Spatial Audio Principles
1-1: 立体音響(サラウンド・3Dオーディオ)の歴史
私たちが今日耳にしている立体音響はいつごろから始まってどのように進化してきたのか?そのことに少し触れてみます。その歴史は私たちが想像するよりもずっと古く、1930年代の映画や実験的なレコーディングから始まっています。
1. 黎明期(1930年代〜1950年代):映画と実験から始まったサラウンド
立体音響のルーツは、映画館の大画面にふさわしい迫力ある音響を作ろうとした試みにあります。
- 世界初のマルチチャンネル映画(1940年): ディズニーのアニメーション映画『ファンタジア』で、世界初のサラウンドシステム「Fantasound(ファンタサウンド)」が導入されました。映画館のスクリーンの後ろだけでなく、客席の後方や側面にもスピーカーを配置し、音が館内を動き回る演出が行われました。
- ステレオの誕生(1950年代): 家庭用オーディオでは、1chの「モノラル」から、左右2つのスピーカーで音の広がりを再現する「2chステレオ」へと進化しました。
2. 4chステレオのブームと挫折(1970年代):早すぎた家庭用立体音響
1970年代に入ると、家庭でも「前後左右」から音を鳴らす4chステレオ(クアドラフォニック)のブームが起きました。
- 規格の乱立: レコード会社やオーディオメーカーがそれぞれ異なる音声規格(SQ、QS、CD-4など)を発表したため、互換性がなく消費者が混乱しました。
- 技術的な限界: 当時のアナログレコードに4チャンネル分の音をクリアに記録し、家庭で4つの大きなスピーカーを正しく配置するのはハードルが高く、このブームは一度衰退してしまいます。
- バイノーラル録音の登場: 1970年代には、人間の耳の構造を模した「ダミーヘッドマイク」を使い、ヘッドホンで聴いた時にリアルな立体感が得られるバイノーラル録音の技術も実用化されました。
3. 映画音響の黄金期(1980年代〜1990年代):5.1chサラウンドの確立
家庭用テレビの大型化やDVDの登場とともに、映画館の立体音響が「ホームシアター」として家庭に普及しました。
- ドルビーサラウンド(1980年代): 映画『スター・ウォーズ』などの大ヒットとともに、ドルビー研究所が開発した音響システムが世界基準になりました。
- 5.1chサラウンドの標準化(1990年代): 前面(左・中央・右)、後方(左・右)の5つのスピーカーと、重低音専用のサブウーファー(0.1ch)を組み合わせた「5.1chサラウンド」が確立されます。DVDやプレイステーション2などのゲーム機に採用され、家庭にも広く浸透しました。
4. 「上下」の概念とオブジェクト音響の誕生(2010年代):ドルビーアトモスの衝撃
2012年、これまでの立体音響の概念を根本から変える革新的な技術が登場します。それが映画『メリダとおそろしの森』で初めて導入されたDolby Atmos(ドルビーアトモス)です。
- チャンネルベースからオブジェクトベースへ: 従来の「左後ろのスピーカーから音を出す」という仕組み(チャンネルベース)から、「空間のこの座標に音を配置する」という仕組み(オブジェクトベース)へ進化しました。これは初めて音がスピーカーというデバイスから解放された瞬間でもありました。
- 「高さ(上下)」の追加: 天井にスピーカーを設置することで、雨が降る音や、頭上をヘリコプターが通過する音を完璧に再現できるようになりました。それ以外にも「DTS:X」や「Auro-3D」なども登場しました。
5. 現代(2020年代〜現在):イヤホンで体験する個人用空間オーディオ
かつては広大な映画館や、たくさんのスピーカーを並べた部屋でしか体験できなかった立体音響が、「ワイヤレスイヤホンとスマートフォン」だけで体験できる時代になりました。
- 空間オーディオの一般化: Apple Musicの「空間オーディオ」や、ソニーの「360 Reality Audio」により、通常の音楽配信でも立体音響が当たり前になりました。
- 計算音声学(コンピュテーショナルオーディオ): イヤホンに搭載されたセンサーが頭の向きを検知する「ヘッドトラッキング機能」や、人間の耳の形に合わせて音の聞こえ方をリアルタイムで補正する技術により、ヘッドホン・イヤホンの中にリアルな3D音響空間を作り出しています。
| 時代 | 主な技術・規格 | 立体音響の特徴 |
|---|---|---|
| 1940年代 | ファンタサウンド(映画『ファンタジア』) | 映画館に複数のスピーカーを並べた初の試み |
| 1970年代 | 4chステレオ、バイノーラル録音 | レコードでの前後左右の再現(規格乱立で一時衰退) |
| 1990年代 | ドルビーデジタル、5.1chサラウンド | DVDの普及とともにホームシアターがブームに |
| 2010年代 | Dolby Atmos、DTS:X | 天井スピーカーによる「上下」の表現、オブジェクト音響 |
| 現代 | 空間オーディオ、ヘッドトラッキング | スマホとイヤホンだけで誰もが3Dサウンドを体感 |
3D立体視において網膜に映る情報のズレを脳が計算するように、人間の聴覚システムも左右の耳に届く音の「わずかな差異」から、その音が空間のどこから発せられたかを常に計算しています。立体音響を理解し、制作・開発するためにはには、人間が音の位置や奥行きをどのように知覚しているか、その生体メカニズムを正しく理解する必要があります。
従来のサラウンドシステムでは、スピーカーごとに音を割り当てるチャンネルベースが中心でした。これに対して近年では、音声を位置情報付きのオブジェクトとして扱い、再生時にスピーカーの配置や再生環境に応じて音の位置を計算・再現するオブジェクトベースが広く使われるようになってきています。さらに、個々の音源だけではなく、空間全体に形成される音場を「球体」として丸ごと捉え、記述・再現するシーンベースという考え方もあります。また、現在のイマーシブコンテンツ制作では、「シーン・ベース」と「オブジェクト・ベース」を組み合わせるハイブリッドなアプローチも重要になっています。
音をどう捉えるか?ということにどのようにアプローチするのかを説明するのがこの章の役割です。そこには音が聞こえるという知覚認知の話から実際に音をどのように記録、記述するかという「空間記述」の話になっていきます。そして記述した音を今度はどのようにミキシングしていくのか、設計していくのかというところへと向かいます。最後にそれらの設計された音をどのように耳に届けるのか、最後の出力のところです。以上のように音響は入ってきた音をどう捉え、記述し、設計し、出力するか。この4つのフェーズに分かれています。この章ではそのうちの前半にあたるどのように捉え、同記述するかまでを説明していきます。次の第3章ではどのように設計していくか、第4章ではどのように出力していくか、を説明します。
ー(図解を入れて分かりやすく説明する)ー
図01:立体音響における3つの空間記述
             立体音響の空間記述
                     │
        ┌────────────┼────────────┐
        ↓            ↓            ↓
   Channel-Based  Object-Based  Scene-Based
        │            │            │
     スピーカー       音源          音場
        │            │            │
   「どのchから」 「どこにある音」 「空間全体」
        │            │            │
        └────────────┼────────────┘
                     ↓
                  Hybrid
             複数方式の組み合わせ
ここではまず、この3つの考え方を全体像として押さえるにとどめておきます。
それぞれがどのような仕組みで空間を記述しているのかについては、のちに1-4の「音の空間記述」で詳しく述べていきます。
1-2: 人間の耳の仕組みと音の空間知覚
立体音響の本質:なぜ人間は「音の3次元」を認知できるのか
人間には耳が2つしかありません。これは鼓膜という2次元(平面)のセンサーしか持っていないことを意味します。にもかかわらず、私たちは「真後ろ」や「真上」、あるいは「迫り来る奥行き」といった3次元の空間座標を、ピンポイント(正確な位置)で識別することができます。脳は、左右の耳に届く音の波形から、次の「主な3つの手がかり」をリアルタイムに解析して空間をマッピングしています。
脳は、左右の鼓膜に届く音の「わずかな変化」を次の3つの指標で常に計算しています。 [1]
- ILD(両耳間レベル差 / Interaural Level Difference)
- 右から音が鳴ると、左耳には「自分の頭(障害物)」に遮られた、少し小さく(減衰して)こもった音が届きます。脳はこの音量差で左右の角度を測ります。
- 現象: 左右の耳に届く音の「音量(レベル)の差」。
- 仕組み: 音源がリスナーの右側にあるとき、右耳には直接音が届きますが、左耳には「自分自身の頭部」という物理的な障害物を回り込んで音が届きます。このとき、特に高周波数(高音)の音は頭部によって遮蔽され、左耳に届く頃には音量が減衰して少しこもった音になります。
- 特徴: 主に高音域において、左右の「角度」を識別するための強力な手がかりとなります。
- ITD(両耳間時間差 / Interaural Time Difference)
- 右からの音は、左耳に届くまでに非常に小さな時間差だけ遅れて到達します。脳はこの超微細な「時間差(ディレイ)」を感知しています。
- 現象: 左右の耳に音の波形が到達する「時間の差(ディレイ)」。
- 仕組み: 音源が右側にある場合、右耳に音が到達してから、左耳に到達するまでには頭の幅の分(約15〜20cm)だけ物理的な距離の遅れが生じます。両耳間の到達時間差はサブミリ秒程度の非常に小さな差であり、人間の聴覚系はこの時間差を利用して水平方向の音源位置を知覚しています。
- 特徴: 主に頭部を回り込みやすい低音域において、音の左右の位置を正確に割り出すために機能します。
- 耳介(耳たぶ)による周波数特性の変化
- 音は「上」から来るときと「後ろ」から来るときで、耳たぶや顔の凹凸に乱反射して特定の周波数がカット・強調されます。人間が「上下・前後」を識別できるのは、この耳の形による音質の変化を脳が学習しているからです。 [1, 2]
- 現象: 音が耳の穴(外耳道)に入る前に、耳たぶや顔の凹凸で乱反射することによって生じる「音質の変化」。
- 仕組み: 前述のILDとITDだけでは、「真正面から来る音」と「真後ろから来る音」の区別がつきません(左右の距離と時間が同じになるため)。しかし、現実の私たちは前後の音をハッキリと聴き分けられます。なぜなら、音の進む方向(上、下、前、後)によって、複雑な形をした耳介(耳たぶ)の皺(しわ)に光のように乱反射し、特定の周波数帯域が削られたり強調されたりして鼓膜に届くからです。
- 特徴: 脳はこの「耳たぶを通過したことによる音質の変化(フィルター効果)」を経験的に学習しており、これによって音の「上下」や「前後」という3次元的な高低・定位をピンポイントで識別しています。
3D映像の「視差」に対応する音の「知覚トリック」
立体映像において「左右のピクセルズレ(Disparity)」が奥行きを作るように、立体音響ではこれら ILD・ITD・耳介のフィルター効果 の3つをデジタル音声信号に対して数学的にシミュレートし、重ね合わせることで、通常の2chヘッドホンであっても「まるで本当に自分の真後ろから誰かが話しかけているかのような」生体錯覚を作り出すことができます。
| 空間の軸 | 脳が認識するための生体手がかり | 3D映像における対応概念 | デジタル音響での制御パラメータ |
|---|---|---|---|
| 左右(水平角) | ITD(時間差)/ ILD(音量差) | 左右画像の水平視差(Disparity) | 左右チャンネルのディレイ(ms)と音量バランス |
| 上下・前後 | 耳介(耳たぶ)による周波数変化 | 垂直・回転アライメント(エラー要素) | 3Dオーディオフィルター(周波数イコライジング) |
| 奥行き(距離) | 音圧レベル、直接音と反射音の比、残響、周波数特性など | 負・正のパララックス(空間深度) | リバーブ(空間反射)の比率と空気吸収フィルター |
ー(図解を入れて分かりやすく説明する)ー
図02:立体音響におけるILD・ITD・耳介のフィルター効果
現場の全レイヤー(クリエイター・プロ・開発者)へのアドバイス
- クリエイターへ:
人間が音の「上下・前後」を感じるためには、耳たぶを通過するような高音域(ディテール)の情報が不可欠です。完全に低音(ベース音など)だけに絞られた効果音は、いくら立体音響ソフトで空間上に配置しても、リスナーは上下や前後の位置を正確に認識できず定位がぼやけてしまいます。立体音響化したいオブジェクト音には、ある程度の高音成分を含めるのが鉄則です。 - プロの録音・音響エンジニアへ:
現実の空間知覚(ILD/ITD)を最もピュアにキャプチャする伝統的な手法が、人間の頭部を模した「ダミーヘッドマイク(Neumann KU100など)」を用いたバイノーラル録音です。フィールドレコーディング(環境音)をシーンベースの素材として収録する際は、こうした生体模倣マイクを用いることで、ポストプロでの加工を最小限に抑えた「本物の空気感」を記録できます。 - システム開発者へ:
ゲームエンジンやXRアプリ内でリアルタイムに3Dオーディオを生成する際、特に前後方向では、音の強さや到達時間の違いだけでは方向を判断しにくいため、耳介によって生じる周波数特性の変化、すなわちスペクトル手掛かりが重要になります。
1-2:頭部伝達関数(HRTF)と個人最適化(SOFA規格)
数学的な鍵:HRTF(頭部伝達関数(Head-Related Transfer Function))
1-1で解説した「ILD」「ITD」「耳介による周波数変化」という3つの手がかりを数学的に統合し、デジタル空間で再現するためのコア技術が「頭部伝達関数(HRTF:Head-Related Transfer Function)」です。HRTFは空間音響をヘッドホン再生へ変換する重要な手段ですが、定位精度はHRTFの個人適合性や再生環境にも依存します。
しかし、HRTFは人間の物理的な身体形状に依存するため、3D立体映像における「ワールドスケール」の調整と同様に、ユーザーごとに最適化(パーソナライズ)しなければ本当の意味での立体音響は成立しません。本節では、HRTFの定義と最新の個人最適化規格について解説します。
① 頭部伝達関数(HRTF)の数理モデルと「頭内定位」の罠
HRTFとは、スピーカーから出た音が「頭部」「顔面」「耳介(耳たぶ)」を通過して鼓膜に到達するまでの音響的な変化(伝達特性)を、空間の全方位(全天球)から測定し、関数(デジタルフィルター)として数理モデル化したものです。
【デジタル空間における3Dオーディオ生成の数式イメージ】
[2Dのモノラル音源] ✕ [特定の座標のHRTFフィルター] = [ヘッドホンから聴こえる3D立体音響]
左右2chのヘッドホンであっても、このHRTFフィルターをリアルタイムに音声データに掛け合わせる(畳み込み演算を行う)ことで、脳を騙し、任意の3次元空間座標(手前・奥・上・下)に音を定位させることが可能になります。
汎用HRTFが引き起こす「頭内定位」というバグ
多くの立体音響システムでは、「ダミーヘッド(人工頭部マイク)」を用いて測定された「汎用(平均的)なHRTF」がプリセットとして使われています。
しかし、人間の耳の形状や頭の大きさは、指紋と同じように一人ひとり全く異なります。自分の体型と合わない汎用HRTFで聴いた場合、脳が空間情報を正しくデコードできず、音が空間に広がらずに頭の芯の中に引きこもって聴こえる「頭内定位(Internalization)」や、「前後の音が逆転して聴こえる」といった致命的な破綻が発生します。
② 個人差の標準化:SOFA規格(Spatially Oriented Format for Acoustics)
この「身体形状の個人差」を解決するために、オーディオ工学の国際学会(AES)によって標準化された共通データ記述フォーマットが「SOFA規格」です。
SOFA(Spatially Oriented Format for Acoustics)は、HRTFを含む音響データを、標準化された形式で記録・交換するためのデータフォーマットです。たとえば、個人の頭部・耳介などの特性を反映したHRTFを測定した場合、その測定データをSOFA形式で保存することで、異なるシステムやソフトウェア間で扱いやすくなります。
重要なのは、SOFAそのものがHRTFを個人最適化する技術ではないという点です。HRTFの測定・推定・個人化と、そこで得られた音響データを標準的な形式で扱うことは、それぞれ別の役割を持っています。つまり、SOFAは「自分専用のHRTFを作る仕組み」ではなく、作成・測定・推定されたHRTFなどの音響データを、共通の形式で扱うための基盤と考えると分かりやすい。
- 定義と仕組み:
SOFAは、HRTFなどの音響データを標準化された形式で保存・交換するためのオープンなデータフォーマットです。個人HRTFの測定や推定そのものを行うものではありませんが、得られたHRTFを異なるシステムやソフトウェアで扱うための共通基盤として利用できます。 - パーソナライズ(耳スキャン)の社会実装:
近年の空間コンピューティングデバイス(Apple Vision Proなど)や、360 Reality Audio(ソニー)等のエコシステムでは、セットアップ時にスマートフォンのカメラ等を用いて「ユーザー自身の耳の形や頭部を3Dスキャン」する工程が導入されています。
システムは、スキャンされた3D形状データからAI(ディープラーニング)を用いてその個人の音響特性を予測し、SOFA規格に準拠した「自分専用のオーダーメイドHRTF」をクラウド上で自動生成・デバイスに適用します。これにより、定位精度や外在化の改善に寄与する可能性があります。HRTFは個人差が大きいため、個人化は空間音響の重要な研究・実装テーマになっています。
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
- クリエイターへ:
YouTubeや配信プラットフォーム向けに3Dオーディオ作品(ASMRやボイスドラマなど)を制作する場合、視聴者の多くは「汎用HRTF」環境で聴くことになります。前後の誤認(バグ)を減らすため、音源を真後ろに配置する際は、あらかじめ高音域(耳たぶで変化する帯域)をわずかに強調するか、セリフに少しだけ「部屋の響き(初期反射)」を混ぜることで、汎用環境でも奥行きを認識しやすくする工夫(ミキシング・トリック)が有効です。 - プロの音響エンジニアへ:
現代のポストプロにおいて、ヘッドホン環境でDolby Atmos等のイマーシブ・ミキシングを正確に行うためには、自身のSOFAプロファイルを取得することが不可欠です。Genelecの「Aural ID」やWavesの「Nx」などのシステムを導入し、スタジオの物理スピーカーのデプス(距離感)を自身の耳の形に合わせてヘッドホン内にキャブレートした状態でミキシングを行ってください。 - システム開発者へ(パーソナライズ・オーディオの実装):
XRアプリケーションやメタバースプラットフォームを開発する際は、内製のオーディオエンジンにSOFAファイルのインポートAPI(WebAudio APIやUnity/UE5のサードパーティプラグイン等)をあらかじめ実装しておく設計を推奨します。アプリ内の全ボイスチャットや環境音がその人の耳に最適化される、次世代のステレオセーフな空間音響体験を提供できます。
1-3:運動視差とヘッドトラッキング(動的インタラクション)
3D立体視において、自分が頭を左右に動かしたときにオブジェクトの側面が見え隠れする現象を「運動視差(Motion Parallax)」と呼びました。音響の世界における運動視差とは、「自分が動いたときに、周囲の音の聞こえ方(時間差や音量差)が現実空間と全く同じようにリアルタイムに変化する現象」を指します。
人間の脳に「この音の空間は本物だ」と認めさせるための最後の鍵が、リスナーの動的なインタラクションと音場を同期させるヘッドトラッキング(Head-Tracking)技術です。
① 動的インタラクションがなぜ必要なのか
1-1および1-2で解説した「個人最適化されたHRTF(SOFA規格)」を適用すれば、静止した状態での音の定位感は飛躍的に向上します。しかし、これだけでは人間の高度な空間認知(知覚システム)に追いつくことはできません。
現実世界において、私たちは音がどこから鳴っているか判断が難しいとき(例:正面か真後ろか曖昧なとき)、無意識に「首をほんのわずかに傾ける」ことで、左右の耳に届くILD(音量差)やITD(時間差)の音の変化を手がかりとして、音源の位置を確定させています。
トラッキングのない3Dオーディオの限界
従来の固定された3Dオーディオ(映画の5.1chをそのままヘッドホンで聴くような環境)では、自分が右を向くと、仮想空間内の音源(例:正面の役者の声)も一緒に右へと回ってしまいます。
これは脳にとって「音が自分の頭の動きに縛り付けられている」という強烈な生体矛盾となり、空間の広がりが失われ、音が頭の中に引きこもる「頭内定位」へと逆戻りしてしまいます。
② ヘッドトラッキング(Head-Tracking)のメカニズム
ヘッドトラッキングは、Apple Vision Pro、Meta Quest、あるいはAirPods Proなどのイヤホンに内蔵されたIMU(慣性計測装置 / ジャイロセンサー・加速度センサー)を利用し、ユーザーの頭部の回転角(Pan、Tilt、Roll)を高速で検出します。
- リアルタイム逆計算(動的レンダリング):
ユーザーが頭を右に30度回転させた瞬間、オーディオシステムは「空間内のすべての音源オブジェクトの座標を、左に30度即座に逆回転」させてHRTFフィルターを再計算します。 - 「空間へのピン留め」効果:
このフィードバックにより、ユーザーが右を向いても、正面にあった役者の声は「物理的な正面の空間(現実世界の元あった場所)」にピン留めされて聴こえ続けます(左耳側に音がシフトする)。脳はこの動的な音の変化を検知した瞬間、初めて「この音はヘッドホンの中ではなく、目の前の物理空間に実在している」と感じます。
静的3Dオーディオ と 動的(ヘッドトラッキング付)3Dオーディオの比較
| 比較項目 | 静的3Dオーディオ(トラッキングなし) | 動的3Dオーディオ(ヘッドトラッキングあり) |
|---|---|---|
| 空間の挙動 | 頭の動きに合わせて音の空間全体が一緒に回る | 自分が動いても、音源は現実空間のその場に固定される |
| 脳の空間錯覚 | 弱い(イヤホンの中で鳴っている感) | 極めて強い(現実にその物体が実在する感覚) |
| 前後・上下の誤認 | 発生しやすい(正面と真後ろを間違える) | ほぼゼロになる(首を少し動かすだけで判別可能) |
| 必要ハードウェア | 通常のイヤホン・ヘッドホン | IMUセンサー内蔵型デバイス(HMD、先端イヤホン等) |
| 主な用途 | 従来のCD、音楽配信、固定画面の動画 | 空間コンピューティング、VR/MRゲーム、LBE展示、次世代映画 |
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
- クリエイターへ(360度動画・VR制作):
YouTubeの360度VR動画向けに音声を実装する場合、音声トラックの出力を通常の「ステレオ(2ch)」ではなく、必ず後述する 「アンビソニックス(Ambisonics / 4ch以上)」 のフォーマットで書き出してください。YouTubeの再生プレイヤーは標準でスマホのジャイロやVRゴーグルと連動するヘッドトラッキングエンジンを搭載しているため、アンビソニックスで書き出すだけで、ユーザーの視線移動に合わせて音が自動で空間にピン留めされる動的インタラクションが実現します。 - プロのMA・ミキシングエンジニアへ:
ヘッドトラッキング環境が前提となるミキシング(Apple Immersive Videoやゲーム用アセット等)では、スピーカーでの定位確認だけでなく、実際にセンサー内蔵のヘッドホン(AirPods Maxや、Nuro Audioの『Ambiance』等の開発者用リグ)を装着し、「首を激しく振ったり、ゆっくり傾けたりした際に、音源のエッジ(輪郭)がブレずにその座標に留まっているか」を動的にクオリティチェックするワークフローを必ず確立してください。 - システム開発者へ(トラッキング・レイテンシーの制御):
ヘッドトラッキングにおいて、3D酔いや違和感を防ぐための最もクリティカルなパラメータが「Motion-to-Sound Latency(頭が動いてから音が補正されるまでの遅延時間)」です。この遅延(レイテンシー)が大きくなるほど、頭部運動と音の変化との不一致が生じ、違和感につながる可能性があります。オーディオのバッファサイズ(Buffer Size)を極限まで小さく設定し、OS側のIMUポーリングレートを高精度に同期させるスレッド設計を最優先してください。
1-4:音の空間記述
これまで、人間が音の方向や距離、奥行きをどのように知覚するのかについて見てきました。ここからは、そのような音と空間との関係を、コンピュータや音響システムがどのように記述し、扱うのかについて考えていきます。
立体音響では、音を単なる音声信号として扱うだけではなく、
「どこから聞こえるのか」
「どのような広がりを持つのか」
「その音がどのような空間に存在するのか」
といった音と空間との関係を記述するという考え方が重要になります。
たとえば、「この音を左のスピーカーから鳴らす」という情報と、
「この音源はリスナーの右前方に存在する」という情報では、
空間の記述方法が大きく異なりるのです。
「空間の何を単位として記述するのか」 立体音響を支える3つの空間記述
前者のようにスピーカーを基準として音を記述するのがチャンネルベース、後者のように音源そのものの位置や属性を記述するのがオブジェクトベースです。さらに、個々の音源ではなく、リスナーを取り囲む空間全体の音場を「球体」として捉え、その空間的な情報を記述するシーンベース(Ambisonics)というアプローチもあり、現在のイマーシブコンテンツでは、それらを組み合わせたハイブリッドな構成も広く用いられています。
つまり、立体音響における「空間記述」とは、
音を「何を単位として」「どのような空間情報とともに」表現するのか
という問題です。
ここで重要なのは、これらが単純な「新旧」や「優劣」の関係ではないということです。それぞれが、空間を記述する際の「何を単位として扱うのか」に違いがあります。
- チャンネルベース(Channel-Based Audio):スピーカーを基準として音を記述する
- オブジェクトベース(Object-Based Audio):個々の音源を基準として記述する
- シーンベース(Scene-Based Audio / Ambisonics):空間全体の音場を基準として記述する
ここから、それぞれの方式がどのように空間を記述し、どのような特徴や限界を持つのかを見ていきます。
Professional Spatial Audio System Architecture & Signal Flow
DAW (Linear Audio Input)
Wwise Audio EngineObject & Bed Inputs360 WalkMix
CreatorPanning Coordinates (X,Y,Z)
Reflection & Geometric
DataADM BWF Broadcast FileMPEG-H 3D Audio CodecMaster Bitstream OutputHW/SW Studio RendererVBAP Spatialization Engine
Binaural
HRTF Processing
Multi-Channel
Speaker Array
MDR-MV1 Studio
HeadphonesLayer
1: Input & DesignLayer
2: Metadata AuthoringLayer
3: Master EncodingLayer
4: Real-time RenderingLayer 5: Monitoring Endpoints
①:チャンネルベース(Channel-Based Audio)──決められたスピーカ位置に音を割り当てた記述
チャンネルベースは、あらかじめ定められたスピーカー配置やチャンネルに対して音声信号を割り当てる方式です。映画音響や従来のサラウンドシステムで広く使われてきた方式で、5.1ch、7.1ch、5.1.4ch、7.1.4chなどが代表的な例です。
構造と特徴:音声信号とスピーカー配置との関係があらかじめ定義されており、規格化された再生環境では制作者の意図を再現しやすいという特徴があります。
メリット:再生システムの構成が明確で、規格化・キャリブレーションされた環境では高い再現性を得やすい。
デメリット:再生環境のスピーカー配置が制作時の想定と異なる場合、音像の位置やバランスが変化する可能性があります。また、リスナーの位置や向きが大きく変化するインタラクティブな環境では、そのままでは柔軟に対応しにくい場合があります。
②:オブジェクトベース(Object-Based Audio)─音源を基準とした空間記述
オブジェクトベースでは、音声信号と、その音源の位置や大きさ、移動などを表すメタデータを分離して扱います。再生時には、そのメタデータをもとに、再生環境に応じた音像定位をレンダリングします。
構造と特徴:スピーカーそのものではなく、音源の空間的な属性を記述するため、再生環境の違いに応じて音像を再配置できる柔軟性があります。代表的な例としてDolby Atmosなどがあります。
メリット:音源の位置や移動を独立して扱うことができ、異なるスピーカー配置や再生環境に対応しやすい。また、インタラクティブコンテンツとの親和性も高い。
デメリット:オブジェクト数やレンダリング処理が増えるほど、システムの計算量や処理負荷が増大します。また、最終的な定位品質はレンダリング方式や再生環境にも左右されます。
③:シーンベース(Scene-Based Audio / Ambisonics)── 空間全体の音場を記述
シーンベースは、個々の音源を独立したオブジェクトとして扱うのではなく、聴取者を取り囲む空間全体の音場を記述するアプローチです。その代表的な方式がAmbisonics(アンビソニックス)です。
Ambisonicsでは、音場を球面方向の情報として捉え、球面調和関数に基づいて数学的に記述します。イメージとしては、「自分を取り囲む空間全体の音を、ひとつの球体として丸ごと捉える」ような考え方です。
再生時には、その音場情報をスピーカー配置やヘッドホン再生などの環境に応じてデコードし、視聴者の向きに合わせて回転させることができます。そのため、VR、180°・360°映像、ドームコンテンツなど、視聴者の向きが変化するメディアと非常に相性がよい方式です。
メリット:空間全体をひとつの音場として扱えるため、視聴者の向きの変化に対応しやすく、環境音や空間の包み込み感を表現しやすい。
デメリット:空間の表現精度は、使用するAmbisonicsの次数や再生環境などに依存します。また、特定の音源を非常に近距離からピンポイントに表現する場合には、オブジェクトベースなど別の方式と組み合わせることが有効な場合があります。
④:ハイブリッド(Hybrid Audio)── 複数の空間記述方式を組み合わせる
実際のイマーシブコンテンツ制作では、ひとつの方式だけですべての音を表現するのではなく、複数の空間記述方式を組み合わせることがあります。
たとえば、環境音や空間全体の響きをシーンベースで包み込みながら、セリフや特定の効果音、移動する音源などをオブジェクトベースとして配置する、といった構成です。
このようなハイブリッドなアプローチによって、「空間全体」と「個々の音源」を異なる粒度で記述し、それぞれの特性を活かした空間音響を設計することができます。
立体音響における空間記述は、ひとつの方式に統一することが目的ではありません。コンテンツの性質、インタラクション、再生環境、そして求める体験に応じて、どのような空間情報を、どの単位で記述するかを設計することが重要です。
なお、「立体音響」「イマーシブオーディオ」「Spatial Audio」「ライブ・イマーシブ」など、イマーシブな音響体験を表す言葉は複数存在します。これらは必ずしも同義ではなく、技術方式、制作手法、再生環境、体験そのものなど、異なる観点から使い分けられています。
第2章:
3D空間における空間オーディオ設計
Spatial Audio Design in 3D Space
第1章では、人間が音の方向や距離、奥行きをどのように知覚するのか、そして音と空間との関係をどのように記述するのかについて見てきました。
第2章では、そこから一歩進み、実際の3D空間の中で音をどのように配置し、どのように変化させるのかを考えていきます。
3D空間に音を置くということは、単に「右から音を鳴らす」「上から音を鳴らす」ということではありません。
音源がどこに存在するのか、
どの程度の大きさや広がりを持つのか、
リスナーとの距離によってどのように音が変化するのか、
さらに、空気や周囲の環境によってどのような影響を受けるのか。
こうした要素を組み合わせることで、音に「空間の中に存在している」という感覚を与えることができます。
本章では、まず音源を3D空間上のどのような存在として扱うのかを考えます。
重要なのは、これらを単なる「音響エンジンの設定項目」として理解しないことです。
これらはすべて、
「3D空間の中に存在する音を、どのような情報としてコンピュータ上に記述するのか」
という問題につながっています。第2章では、音を3D空間に「置く」ための設計原理を整理していきます。
2-1:立体音響レンダリングの考え方 ― 近似モデルと物理シミュレーション
3D CG空間(Blender、MAYA、Cinema 4Dなど)やリアルタイムのゲームエンジン(Unity、Unreal Engine 5など)の中で、立体音響空間を構築するためには、音源オブジェクトから発せられた音が「空間の壁や床にどう反射し、リスナーの耳にどう届くか」を計算(レンダリング)する必要があります。
この立体音響レンダリングのアプローチには、大きく分けて「特徴予測方式(Predictive Rendering)」と「レイトレース方式(Acoustic Ray Tracing)」の2つの手法が存在します。これらは計算負荷と表現の正確性が根本から異なり、コンテンツの性質やデバイスの性能に応じて使い分ける必要があります。
① 特徴予測方式(Predictive Rendering)
- 幾何学的アプローチ:
あらかじめ空間(部屋)の広さ、形状、大まかな素材(コンクリート、木材など)といった静的な空間データをベースに、発生する残響(リバーブ)の減衰パターンや特性を事前に予測・マッピング(プリバケ Pre-Bake)しておく手法です。 - 特徴:
音源が動いても、あらかじめシミュレートされた空間全体の「残響空間(環境エフェクト)」の容積の中に音が配置されるため、動的な形状変化に対するリアルタイムな再計算を行いません。
⭕ メリット
- 計算負荷が極めて低い:
事前に予測された数値を基に音声DSP(デジタル信号処理)を施すだけなので、CPUやGPUへの負荷が最小限に抑えられます。 - フレームレートの維持が容易:
第4章で解説した「120fpsの常時維持」が絶対条件となるHMD環境において、オーディオ処理が原因で画面が引っ掛かるリスクをほぼゼロにできます。
❌ デメリット
- 動的な遮蔽(しゃへい)に対応できない:
プレイヤーと音源(例:爆発音)の間に「急に巨大な防音壁が倒れてきた」としても、音が壁に遮られてリアルタイムにこもる(遮蔽効果)といった空間の変化を動的に表現することは不可能です。
② レイトレース方式(Acoustic Ray Tracing / 音線シミュレーション)
- 幾何学的アプローチ:
3D CG空間の物理シミュレーションとして、音源から「音の線(音線:Sound Ray)」を全方位に放射(キャスト)し、それが壁やオブジェクトに衝突・反射・減衰・回折などの音響現象を幾何学的にシミュレーションする手法です。 - 特徴:
グラフィックス技術の「レイトレーシング(RayTracing:光線追跡)」と全く同じロジックを、音の波(球面波・反射波)の挙動に対して適用します。
⭕ メリット
- 極限までフォトリアル(音響リアル)な空間再現:
空間内の形状変化(ドアが開閉する、遮蔽物の影に隠れる)に対して、音が回って聞こえる「回折(Diffraction)」や、素材に応じた厳密な反射音が動的にシミュレートされます。 - 圧倒的な没入感:
ユーザーが首を動かした際(ヘッドトラッキング)の、壁からの跳ね返り音の変化(運動視差)が計算されるため、脳に「今、自分は本物の物理空間にいる」と錯覚させることができます。
❌ デメリット
- 処理負荷の爆発(CPU/GPUへの高い要求):
3D空間のポリゴン数(幾何学的複雑さ)に比例して計算量が幾何級数的に跳ね上がります。オーディオエンジンの処理が追いつかなくなると、音が遅延したり、アプリケーション全体のパフォーマンス(fps)が低下してVR酔いを誘発します。
特徴予測方式 と レイトレース方式の比較まとめ
| 比較項目 | 特徴予測方式(Predictive Rendering) | レイトレース方式(Acoustic Ray Tracing) |
|---|---|---|
| 計算のタイミング | 事前計算(プリバケ) / 固定パラメータ | リアルタイム動的シミュレーション |
| 処理負荷(CPU/GPU) | 極めて低い(軽量・量産向き) | 非常に高い(ハイエンドPCなど必要) |
| 動的な空間変化への追従 | 不可(一定の響きを維持) | 完全に追従(遮蔽、回折、動的リバーブ) |
| 主な3D対応ソフト | Cinema 4D、Blender(標準オーディオ) | Unity(Meta XR Audio)、UE5(Audio Synesthesia) |
| 最適なユースケース | 360度動画の環境音、モバイルXR、大人数マルチ | ハイエンドVR、空間コンピューティングアトラクション |
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
- クリエイターへ(CGソフトでのレンダリング):
BlenderやCinema4Dなどの3D CGソフトで立体音響をレンダリングする際は、まずは標準搭載されている「特徴予測ベース」のスピーカー・オブジェクト配置から始めてください。空間の壁の材質(吸音率)をマテリアルプロパティ側で正しく設定しておくだけで、複雑なコードを書かなくても、書き出したL/R(またはアンビソニックス)の動画に自然な部屋の響きが自動で反映されます。 - プロの音響エンジニアへ:
レイトレース音響が有効なゲームやMRの現場では、高精細なポリゴンモデルをそのまま音の計算に流用するとシステムクラッシュします。そのため、実務ではビジュアル用の高解像度メッシュとは別に、音の反射計算専用の「極限までポリゴン数を削ったシンプルな箱状の『音響用衝突メッシュ(Acoustic Geometry)』」をVFXチームと連携して用意・配置するのが、プロの現場の標準ワークフローです。 - システム開発者へ(動的ハイブリッドシステムの構築):
Unreal Engine 5の「Audio Gameplay Volumes」やMetaの「Acoustic Ray Tracing API」を実装する際は、すべての音にレイトレースを適用するのではなく、プレイヤーから一定距離以上離れた背景の音や重要度の低い環境音(アンビエンス)は「特徴予測方式(プリセットリバーブ)」に逃がし、主役のセリフや敵の足音など、位置特定(定位)が重要なクリティカルな音源にのみ「レイトレース方式(音線キャスト)」を割り振りように配分してください。
立体音響レンダリングの2つのアプローチはそのままCGのレンダリングや注意点と同じです。LODと呼ばれる見えるディテールに応じて計算方式を変えるというもので、音響に関しても同じ論理が成り立っています。
2-2:音源の座標化とパラメータ制御(距離減衰・空気吸収の設計)
3D空間に音を配置する作業は、2Dのステレオミキシングのように左右に音を振る(パンニング)のことではありません。
立体音響における音源の配置とは、3D空間内の仮想の点(座標点)に音を実在させ、リスナーとの物理的な幾何学関係から、「距離減衰(Distance Attenuation)」や「空気吸収(Air Absorption)」といった自然界の物理現象を数学的に計算・再現するパラメータ制御を指します。
(1)音源の座標化:点源(Point Source)と面源(Area Source)
1. Point Source ― 点音源
Point Source(点音源)とは、音源を3D空間上の一点に集中した音源としてモデル化する方法です。
たとえば、3D空間の座標(X・Y・Z)によって音源の位置を指定し、その位置を基準としてリスナーとの方向や距離を計算します。
イメージとしては、
「この場所に音源が存在している」
という情報を、コンピュータ上に置く方法です。
ゲームやVRコンテンツでは、人物の声、銃声、楽器、機械音、環境音など、特定の位置から発生していると考えられる多くの音をPoint Sourceとして扱うことができます。
音源の位置が変化すれば、その移動に合わせて音の方向や距離も変化します。
たとえば、リスナーの右側にある音源が前方へ移動すれば、音の定位もそれに合わせて変化します。さらに音源が遠ざかれば、「距離減衰(Distance Attenuation)」によって音量を変化させることができます。
このようにPoint Sourceは、位置、方向、距離、移動といった空間情報を扱うための、3D音響における基本的なモデルです。ただし、現実の音源は必ずしも一点から音を発しているわけではありません。人間の声、車、ステージ上の楽器、滝、群衆など、実際にはある程度の大きさや広がりを持っています。そのため、音源そのものの大きさや広がりを表現したい場合には、Point Sourceとは異なるモデルが必要になります。
2. Area / Volumetric Source ― 広がりを持つ音源
現実の音源には、点ではなく面や体積として広がっているものがあります。たとえば、
- 大型スクリーンやスピーカーアレイ
- ステージ上の楽器群
- 車両や航空機
- 群衆
- 雨や滝
- 炎や機械設備
などです。こうした音源をすべて一点に置いてしまうと、音源の大きさや広がりを十分に表現できない場合があります。そこで、音源を「Area Source(面音源)」や「Volumetric Source(体積音源)」としてモデル化します。
「Area Source(面音源)」では、音源をある面の広がりを持った存在として扱います。一方、「Volumetric Source(体積音源)」では、音源が一定の体積を持つ領域として存在していると考えます。これは単に「音を大きくする」という話ではありません。
音がどこから発生しているように聞こえるのか、その空間的な広がりを設計するためのモデルです。
たとえば、ステージ全体から音が発生しているように感じさせたい場合、単一のPoint Sourceとして中央に音源を置くよりも、複数の発音位置や広がりを持った音源としてモデル化した方が、空間的な存在感を表現しやすくなる場合があります。
ただし、Area / Volumetric Sourceの扱い方は、使用する音響エンジンやレンダリング方式によって異なります。
したがって、「面音源なら必ずこう聞こえる」という単一の結果があるわけではありません。
重要なのは、
音源を「一点」として扱うのか、それとも「広がりを持った空間的な存在」として扱うのか
という設計上の選択です。
- 点源(Point Source)
- 概念: 空間内の特定の1点(X, Y, Zの単一座標)から全方位に向かって球面波として放射される音源モデル。
- 用途: キャラクターのセリフ、スマートフォンの電子音、銃声、足音など、発音位置がピンポイントで特定できるオブジェクト。
- 面源・体積源(Area / Volumetric Source)
- 概念: 1点ではなく、特定の「広がり(球体、立方体、平面の面積)」を持った3D形状から放射される音源モデル。
- 用途: 巨大な滝の音、激しい雨、押し寄せる波、燃え盛る広範囲の炎など。リスナーがそのオブジェクトに近づくにつれて、音が周囲を包み込むような動的なアンビエンスへとシームレスに変化する制御を行います。
(2)距離減衰(Distance Attenuation)のシミュレーション
現実世界において、音源から離れるほど音量が小さくなる現象をデジタル空間で再現するのが距離減衰のパラメータ制御です。音響システムでは、主に以下の3つの減衰曲線(ロールオフ・モデル)を使い分けます。3D空間に音源を配置すると、リスナーとの距離に応じて音の大きさを変化させる必要があります。これが「距離減衰(Distance Attenuation)」です。
現実の空間では、音源から離れるほど音は小さくなります。自由音場における点音源では、距離が2倍になると音圧レベルは概ね6 dB低下します。この関係は、物理的な距離感を考える際の基本的な近似として利用できます。
ただし、実際のイマーシブコンテンツでは、必ずしもこの物理モデルをそのまま使用する必要はありません。ゲーム、VR、映像作品などでは、演出上の意図や再生環境に応じて、距離による音量変化を調整することがあります。そのため、音響エンジンでは一般に、距離に対する音量変化をロールオフ(Roll-off)曲線として設定します。
代表的な考え方として、次の3つがあります。
- ① Linear(リニア)
- 距離が増えるにつれて、音量をほぼ一定の割合で直線的に減衰させる方法です。
- 計算が単純で扱いやすく、音源が一定の距離範囲で徐々に遠ざかっていくような演出に向いています。一方で、実際の音響空間における距離減衰とは異なるため、物理的な距離感を忠実に再現する目的には適しません。
- ② Logarithmic / Inverse系(対数・逆距離系)
- 距離が近いほど音量が大きく変化し、遠くなるにつれて変化が緩やかになる減衰モデルです。
- 現実の自由音場における距離減衰に近い挙動を持つため、自然な距離感を表現しやすい方式です。特に、音源とリスナーの距離そのものを重要な情報として扱う場合に適しています。
- ③ Custom Curve(カスタムカーブ)
- 制作者が距離と音量の関係を自由に設定する方法です。
- 物理的な減衰をそのまま再現するのではなく、「この距離までは存在感を保ち、それ以降で急激に遠ざける」といった演出上の設計が可能になります。
たとえば、遠くにいる人物の声を完全に消してしまうのではなく、一定距離まで明瞭に聞かせ、その後ゆっくり減衰させるといった調整ができます。
重要なのは、これらのロールオフ曲線を**「どれが正解か」という問題として捉えないこと**です。
物理モデルは現実の距離感を再現するための基準になりますが、イマーシブコンテンツでは、映像との整合性、物語上の重要度、インタラクション、再生環境などによって、あえて物理モデルから外れた減衰曲線を選択することがあります。
したがって「距離減衰(Distance Attenuation)」は、
「距離が離れたら音を小さくする」ための機能ではなく、「音の距離感をどのように設計するか」を決めるための空間設計パラメータ
【距離減衰の3大ロールオフ・モデル】

1. 対数減衰(Logarithmic / インバース・ディスタンス)【現実準拠】
   ──> 距離が2倍になるごとに音量が約6dB(半分)減衰する、物理法則に最も忠実なカーブ。
2. 線形減衰(Linear)
   ──> 距離に比例して直線的に音量が小さくなるカーブ。空間の境界をハッキリさせたいUIやエフェクトに有効。
3. カスタム減衰(Custom Roll-off)
   ──> 演出意図に合わせて、特定の距離まで音量を維持し、その後急激に減衰させる独自のカーブ。
限界値(Min / Max Distance)の設計
実務において最も重要なパラメータが 「最小距離(Min Distance)」 と 「最大距離(Max Distance)」 の設定です。
- 最小距離(Min Distance):
これ以上音源に近づいても音が大きくならない限界の境界線。これを設定しないと、リスナーのカメラが音源にめり込んだ瞬間に音量が無限大(デジタルクリップ)になり、スピーカーや耳を破壊するエラーになります。 - 最大距離(Max Distance):
音の聞こえる限界の距離。この距離を超えた音源は、システムのCPU/GPU負荷(ドローコール)を削減するため、自動的にオーディオエンジンの計算対象から除外(カリング)されます。
(3) 空気吸収(Air Absorption / 距離に応じた高音の減衰) 空気による音の吸収
音は空気中を伝わる過程で、空気そのものの影響を受けます。
その代表的な現象が「Air Absorption(空気吸収)」です。一般に、音が長い距離を伝わるほど、高い周波数成分が相対的に減衰しやすくなります。そのため、近くにある音は明瞭で高域まで豊かに聞こえる一方、遠くにある音は高域が徐々に失われ、少し柔らかく、こもった音として知覚されることがあります。
この変化は、単純な「音量が小さくなる」という距離減衰とは異なります。
Distance Attenuationが主として音のレベル変化を扱うのに対して、
Air Absorptionは距離に伴う周波数特性の変化を扱います。
イメージすると、
近距離
明瞭な音
↓
距離が増える
↓
音量が低下するとともに、高域成分も徐々に減衰
↓
遠距離
柔らかく、こもった音
という変化になります。
3D音響システムでは、この現象を周波数フィルターなどによって近似的に再現することがあります。ただし、実際の空気吸収量は、距離だけで決まるわけではありません。周波数、温度、湿度、気圧などの条件によっても変化します。そのため、コンテンツ制作では、物理的な空気吸収を厳密に再現する場合と、演出上の距離感を優先して簡略化する場合があります。
重要なのは、
「遠くの音を小さくする」だけではなく、「遠くの音をどのような音質として聞かせるか」まで設計する
ということです。
Distance AttenuationとAir Absorptionを組み合わせることで、音量だけでは表現しにくい距離感や空間の奥行きを、より自然に表現することができます。
本当の立体音響(奥行き)を表現する上で、音量(距離減衰)以上に脳へ強力な手がかりを与えるのが「空気吸収(Air Absorption / 周波数依存の減衰)」です。
- 物理現象のロジック:
現実の空気中を音が進むとき、「高音(高周波数帯域)」ほど空気の分子に吸収されて急速に減衰し、こもった音になるという性質があります。遠くの雷の音が「ゴロゴロ」と低くこもり、近くの雷が「バリバリ」と高く裂けるように聴こえるのはこのためです。 - デジタル空間での実装(ローパスフィルターの連動):
3Dオーディオエンジン内では、リスナーと音源の距離プロパティに連動して作動する動的なローパスフィルター(Low-Pass Filter / カットオフ周波数の制御)を実装します。音源が10m、50mと遠ざかるにつれて、自動的に高音域(4kHz〜8kHz以上)のシェルフをなだらかに削り落としていきます。
脳はこの「高音のこもり具合」を無意識に解析することで、音量だけでは判別しにくい「音の絶対的な遠さ(奥行き)」を正確に知覚します。
3D音源パラメータの設計テンプレート
ハンドブックの設計シートとして、あるいはUnityやUnreal Engine 5のインスペクタ設定の基準としてそのまま活用できる物理パラメータの推奨値です。
| パラメータ名 | 制御する物理・幾何学量 | 推奨される設計のセオリー | 失敗した際のリスク(バグ) |
|---|---|---|---|
| Position (X, Y, Z) | 3D空間内の絶対座標 | ビジュアル(3Dメッシュ)の中心、または発音部位に完全一致させる。 | 映像の3D位置と音の定位がズレる(認知矛盾) |
| Min Distance | 減衰が始まる最短の境界線 | 人間のキャラクターの場合、「0.3m 〜 0.5m」 前後に設定する。 | カメラが近づいた瞬間に爆音で割れる(ステレオ破綻) |
| Max Distance | 音が完全に消失する最遠の境界線 | ステージの広さに応じて、カリング(計算除外)が自然に繋がる距離を設定。 | 遠くの不要な音がCPUを圧迫し、fpsが低下する |
| Air Absorption (HF) | 高周波数の空気吸収率 | 距離10mを超えたあたりから、1k〜2kHzの減衰を緩やかに開始させる。 | 100m先にあるはずの音が、目の前で囁いているように聴こえる |
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
- クリエイターへ:
3D空間に配置した音が「どうしても遠くに感じられない」ときは、音量を下げる(減衰させる)のではなく、イコライザーで高音を少し削ってみてください。人間の脳は、音が小さくなることよりも、高音がこもることに対して「物理的な距離の遠さ」を強く実感するようにできています。 - プロの音響エンジニアへ:
「面源(Volumetric Source)」を設定する際は、その範囲(スプレッド/Spreadパラメータ)の広がり方に注意してください。リスナーがそのエリアの内部に入った瞬間、音が急激に「モノラル(中央に張り付く)」にならないよう、エリアの内側(インナーコーン)では音を全方位(アンビソニックス等)に滑らかに拡散(ブレンド)させる減衰カーブを綿密にオーサリングする必要があります。 - システム開発者へ(動的周波数減衰マトリクスの実装):
ゲームエンジン内で独自のオーディオDSP(デジタル信号処理)コンポーネントを設計する際は、
※ Min_Frequency には 200.0 (Hz) などを指定します
- のような単純な線形ローパス計算ではなく、大気の温度や湿度(環境要因)の変数を掛け合わせた、音響工学的に正確な周波数減衰モデル(ISO 9613-1等に準拠した指数関数カーブ)をバックエンドに組み込んでください。これにより、砂漠シーンでは乾いた距離感、霧のシーンでは激しくこもる距離感など、グラフィックスと完全に同期した最高峰のイマーシブ音響インフラが完成します。
ここまでのまとめ
Point Source / Area・Volumetric Source ↓
「音源をどのような空間的存在として記述するか」
Distance Attenuation
「距離によって音のレベルをどう変化させるか」
Air Absorption
「距離によって音質・周波数特性をどう変化させるか」
Spatial Perception
「リスナーが距離・奥行き・空間的存在感として知覚する」
これらの構造の中で第1章の
「人間はどのように空間を知覚するのか」
から、この第2章の
「コンピュータはその空間をどう設計するのか」
へつながっていきます。
2-3:オーディオ・バジェット(音のリソース配分)とセーフティ
Audio Budgeting & System Safety
3D立体映像の制作において、画角内に収める奥行きの総量を制限するデプスバジェット「深度設計(Depth Budget)」の管理が不可欠であったように、立体音響のシステム実装においても、ハードウェアの計算リソースを定量的に管理・制限する「オーディオ・バジェット(Audio Budget / 音のリソース配分)」の設計が極めて重要です。
HMD(ヘッドセット)を用いた空間コンピューティング環境では、フレームレートの低下が致命的なVR酔いを誘発します。本節では、3D空間内で立体音響(特に負荷の高いレイトレース方式)を安定動作させるための管理戦略とセーフティ(安全機構)について解説します。
① オーディオ・バジェット(音のリソース配分)の構成要素
立体音響エンジンが消費する計算リソース(CPU/GPU)は、主に以下の3つの要素の掛け算によって決定されます。開発者は、全体の処理負荷がシステム全体の「約5%〜10%以内(オーディオ枠)」に収まるよう設計枠をデザインします。
- 最大同時発音数(Max ボイス数 / Voice Count)
- 空間内で同時に再生される物理的な音声データの総数。
- 3Dオーディオのレンダリング・パス数(空間処理負荷)
- 各音源に対して、1-2および2-1で解説した「HRTF畳み込み」や「レイトレース音線キャスト」を何本実行するかという空間的な処理強度。
- サンプリングレートとバッファサイズ(レイテンシー負荷)
- HMDのMotion-to-Soundレイテンシー(20ms以内)を維持するためにバッファサイズを小さくするほど、CPUの割り込み処理負荷は幾何級数的に跳ね上がります。
② リソースを最適化する3つのインテリジェント・セーフティ機能
3D空間内で大規模なバトルシーンや複雑な都市環境を描写する際、すべての音源にフルスペックの立体音響(レイトレース等)を適用すると、一瞬でシステムがクラッシュするか処理落ち(スタッター)を発生させます。これを防ぐため、オーディオエンジンには以下の動的なセーフティ(制限機構)を実装します。
1. 物理ボイスと仮想ボイス(Virtual Voicing)の動的切り替え
- 仕組み: システムの最大同時発音数(例:64ボイス)の限界を超えた場合、優先度の低い音(遠くのガヤや小さな環境音)の音声デコードやDSP計算を物理的に停止し、無音のまま位置の座標計算(データ追従)だけを維持する「仮想ボイス(Virtual Voice)」状態へと退避させます。
- 効果: リスナーがその音源に近づいたり、主役の音が鳴り止んだ瞬間に、シームレスに「物理ボイス」へと復帰(フェードイン)させることで、聴覚上の違和感を無くしつつCPU負荷を一定にクランプ(制限)します。
2. 距離に基づくカリング(Distance Culling)と音源のLOD(Level of Detail)
- 3Dグラフィックスにおいて遠くのポリゴン数を減らす「LOD」と同様の概念を音響にも適用します。
- 至近距離(LOD 0): フル解像度HRTF + 動的レイトレース反射(最高負荷)。
- 中距離(LOD 1): 汎用HRTF + 簡易的な特徴予測リバーブ(中負荷)。
- 遠景(LOD 2 / カリング対象): 2Dモノラル減衰のみ、または最大距離(Max Distance)超過による完全な計算停止(カリング / ゼロ負荷)。
3. 音源の動的クラスタリング(Sound Clustering / グルーピング)
- 仕組み: 例えば「群衆のざわめき」や「数十発のマシンガンの銃声」のように、狭いエリアに大量の点源(Point Source)が密集した場合、それらを個別に3Dレンダリングするのをやめ、システム側が自動的にそれらを1つの大きな「面源(Area/Volumetric Source)」または「ステレオ/アンビソニックスの1つのグループ」へと統合(クラスタリング)して計算します。
- 効果: ドローコール(レンダリング命令)を1つに統合できるため、空間の臨場感を維持したまま、計算負荷を劇的に削減できます。
空間コンピューティング(HMD環境)におけるオーディオ予算設計シート
ハンドブックのシステム要件定義、あるいはゲームエンジン(Unity/UE5)のオーディオ設定マニフェストとしてそのまま使用できる安全基準のテンプレートです。
| 設計項目 | ターゲット環境(ハイエンドHMD) | ターゲット環境(モバイルXR/スマホ) | セーフティが作動する境界線 |
|---|---|---|---|
| 最大物理ボイス数 | 64 〜 96 ボイス | 32 ボイス | これを超えると優先度の低い音が仮想ボイス化 |
| レイトレース同時実行数 | 最大 16 音源まで(主役・敵の音など) | 原則使用しない(特徴予測に限定) | 予算超過時は自動的に特徴予測リバーブへフォールバック |
| オーディオバッファサイズ | 128 samples (約2.6ms) | 256 samples (約5.3ms) | 処理落ち(プチノイズ)発生時は256/512へ動的拡張 |
| 割り当てCPU最大枠 | システム全体の 8% 以内 | システム全体の 5% 以内 | スレッド負荷が10%を超えたら遠景の音をカリング |
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
- クリエイターへ(アセット制作のルール):
3D空間に配置する音声素材(WAVファイルなど)は、BGMや環境音などの特別な理由がない限り、「すべてモノラル(1ch)」で書き出してください。最初からステレオ(2ch)で録音された素材を3D空間の1点(座標)に配置すると、オーディオエンジンが左右それぞれに対して二重にHRTF計算を行うため、負荷が単純に2倍になり、かつ空間の定位もぼやけてしまうというバグ(失敗)に繋がります。 - プロのサウンドデザイナーへ:
ミキシングの段階で、すべての音声オブジェクトに「ボイス・プライオリティ(発音優先度:0〜255)」の数値を厳密に設定してください。主役のセリフや重要なシステムUIの警告音の優先度を「最高(255)」にし、背景の風の音や足音を「低(50〜100)」にしておくことが、激しいアクションシーンでシステムセーフティ(仮想ボイス化)が正しく機能するための絶対条件です。 - システム開発者へ(動的負荷追従型オーディオマネージャーの実装):
メインのゲームループやアプリのレンダリングスレッド側から、現在のフレームレート(fps)を常時監視するマネージャークラスを記述してください。
グラフィック側の負荷が高まり、目標フレームレート(例:90fps)を割り込みそうになった瞬間、オーディオエンジン側に対して「レイトレースの音線(レイ)のキャスト本数を30%削減する」、あるいは「中距離のLOD 1への切り替え境界線をプレイヤー側に引き寄せる」といった、グラフィックスの安定性をオーディオの解像度低減で補う(動的オーディオダウンスケーリング)セーフティシステムを構築してください。これにより、ユーザーをVR酔いの危険から完全に守り抜く、極めて堅牢な空間コンピューティングインフラが完成します。
ここで、空間音響の制作の流れを説明しておきます。
空間オーディオ(立体音響)の全体的な制作・実装プロセスは、アイデアの段階から最終的な出力まで5つのステップでシームレスにつながっています。
ステップ1:概念・システムの基本設計(要件定義) 最初に「どんな音響演出をするか」のアイデアと、「システムをどう安定させるか」のルール(枠組み)を決めます。
- 目的設定: ユーザーに「その場にいる感覚(没入感)」を与えるための音響構成を計画。
- 負荷の割り当て(オーディオ・バジェット): CPU/GPUのリソース枠(通常全体の5〜10%以内)や、許容遅延時間(20ms以内)を定義。
- セーフティ機能のルール化: 処理が重くなった際に音を間引く「音のLOD(距離減衰)」や「仮想ボイス(無音化)」の基準を決める。
ステップ2:サウンドアセットの制作(素材準備) 設計ルールに従って、音の素材(効果音やBGM)を制作・調整します。
- モノラル音源(1ch)化: 点音源(座標)として配置する効果音は、二重の計算負荷を防ぐためすべてモノラルで書き出す。
- アンビソニックス素材の準備: 空間全体を包み込む環境音(風や雑踏)を全方位録音または生成する。
ステップ3:ミドルウェアでの制御・ミキシング(Wwise / FMOD等) 素材をオーディオミドルウェアに取り込み、インタラクティブ(動的)な挙動や音場を構築します。
- 3D空間パラメーターの適用: 距離による音量減衰、壁による遮蔽(ローパスフィルター)、残響(リバーブゾーン)を設定。
- ボイス・プライオリティ(優先度)設定: セリフや警告音を「高(255)」、環境音や足音を「低」に設定し、負荷オーバー時の自動制御に備える。
- 実機ミキシング: HMD(ヘッドセット)を装着し、頭を動かしたり移動したりしながら音のバランスを微調整。
ステップ4:ゲームエンジンへの組み込み・自動制御(Unity / UE) ミドルウェアのデータをゲームエンジンと連携させ、シーン内のオブジェクトやコードと紐付けます。
- 動的ダウンスケーリングの実装: 画面の描画負荷が高まった際、リアルタイムで音の計算精度を落とすプログラミングを組む。
- 実機テスト: 処理落ち(VR酔いの要因)や音の途切れが発生しないか負荷をモニタリング。
ステップ5:出力方式(フォーマット)の割り当て・レンダリング ミドルウェア内の各ミキサーバスを通して、最終的な音の形式(ベース)へ振り分けて出力します。
- オブジェクトベース出力: 敵の足音やUI効果音などを、位置情報(X, Y, Z coordinates)を持たせたままHMDや立体音響エンジンへ渡す。
- シーンベース出力: 背景の環境音を球状の音場(Ambisonics)として出力し、首の回転に合わせて音場全体を動かす。
- チャンネルベース出力: 2DのBGMやシステムSEを固定のステレオ/サラウンド(2.0ch/5.1ch等)で出力する。
要約すると、「設計(ルール決め)」 → 「制作(モノラル化)」 → 「ミキシング(ミドルウェア)」 → 「組込(動的制御)」 → 「出力(フォーマット割り当て)」という工程を経て、没入感のある空間オーディオ体験が完成します。
また、
ステップ4でゲームエンジン(UnityやUnreal Engineなど)を使用する最大の理由は、「画面内の映像(3D空間)やユーザーの動きと、音声をリアルタイムに連動・制御するため」です。
WwiseやFMODなどのミドルウェアは「音の出し方やルールを定義するツール」ですが、それ単体では「画面の中で今何が起きているか」を把握できません。そのため、世界そのものを動かしているゲームエンジンが必要になります。
具体的な理由は以下の3点です。
- 3D空間の「位置情報」や「プレイヤーの動き」をリアルタイムで音に伝えるため
- プレイヤーがどこを向き、どのスピードで移動しているかというデータ(座標・角度)はゲームエンジンが管理しています。
- ゲームエンジンがそのデータをオーディオミドルウェアに毎フレーム転送することで、初めて「頭を右に向けたら左から音が聞こえる」という立体音響の追従が成立します。
- ゲーム内の「出来事(イベント)」と音を連動させるため
- 「壁に弾が当たった」「扉が開いた」「敵を発見した」といったインタラクションのトリガーを発動させるのはゲームエンジン側のプログラムです。
- エンジン側からミドルウェアへ「音を鳴らせ」という命令(イベント通知)を出すことで、映像と音が完璧なタイミングで同期します。
- システム全体の「描画負荷」と「音響負荷」をまとめて管理・調整するため
- ゲームエンジンは、画面の描画処理(FPS/フレームレート)の負荷状況を常に監視しています。
- 処理落ちが生じそうな場合、ゲームエンジンのプログラム(動的ダウンスケーリング)からミドルウェアに対して「音の計算精度を下げてCPUの負荷を下げろ」と命令を出し、アプリ全体のクラッシュやVR酔いを未然に防ぎます。
実際にゲーム以外の領域(ライブコンサート、展示会、ドーム音響など)でも、ゲームエンジンが使われるケースは非常に多いです。
ただし、会場の形態や演出のスタイルによって「ゲームエンジンを使う場合」と「使わない(専用のライブ音響システムを使う)場合」の2つに大きく分かれます。
1. ゲームエンジン(Unreal Engine / Unity)を使うケース
演出に「リアルタイムのインタラクティブ性(双方向性)」や「リアルタイム3Dグラフィックとの連動」が絡む場合にゲームエンジンが採用されます。
- 演者や観客の動きに音をリアルタイム追従させる演出
- 演者の体に位置センサー(トラッキングシステム)をつけ、ステージ上を走る演者の動きに合わせて「声や効果音の定位(聞こえる位置)」を追従・移動させる場合。
- 観客の移動や視点(バーチャルライブやAR演出など)に合わせて音がリアルタイムに変化する場合。
- 巨大VFXスクリーン(LEDビジョン)との同期
- 近年のライブ演出(バーチャルプロダクション)では、背景の巨大LEDに表示する3D映像をUnreal Engineで生成することが増えています。この際、映像内の3Dオブジェクトの動きと立体音響の位置情報をゲームエンジン上で一括管理・動かす方が効率的であるためです。
2. ゲームエンジンを使わない(専用のライブ音響システムを使う)ケース
一般的なリアル空間でのライブコンサートや演劇、商業施設などでは、ゲームエンジンではなく「ライブ音響専用の立体音響プロセッサー」が使われるのが主流です。
- 代表的な専用システム:
- L-ISA(L-Acoustics社)
- d&b Soundscape(d&b audiotechnik社)
- d&b / Spatial Audio などのハードウェアプロセッサー
- 使わない理由:
- 決まった演出の再現性: 事前に決められた「音の移動ルート(オートメーション)」やマルチトラック音声を正確に再生するだけであれば、DAW(音楽制作ソフト)とこれらの専用プロセッサーを直結する方が安定し、レイテンシー(遅延)も極めて低いためです。
- スピーカーアレイの物理補正: ライブ会場では何十台ものスピーカーを配置するため、会場固有の音響特性(反射やスピーカーの距離差)を補正することに特化した専用機材の方が適しています。
まとめ
- 「あらかじめ決まった動き・演出を再生するライブ」 ➱➱ 専用のライブ音響プロセッサーやDAWが主役(ゲームエンジンは不要)。
- 「人やカメラの動きに合わせて音や映像がリアルタイムに変化するライブ・展示」 ➱➱ ゲームエンジンが「3D位置計算の司令塔」として大活躍する。
さて、
音響に関してミドルウェアはなぜ必要なんでしょうか?ミドルウェアの位置付けは、「音素材(WAVなどのデータ)」と「最終的な出力(ゲームエンジンやライブ音響プロセッサー)」の間に挟まり、「音に『意志』や『インタラクティブなルール』を与える翻訳機・演出家」と捉えると分かりやすくなります。
1. 分かりやすい「例え」
オーディオミドルウェアは、「演劇の舞台」に例えると一発で理解できます。
- 音素材(DAWで作るWAV) = 役者(声や演技のスキルはあるが、いつ舞台に出るか分かっていない)
- ゲームエンジン / 音響システム = 舞台(劇場)(照明や大道具、観客の位置を管理する場所)
- オーディオミドルウェア = 舞台監督・演出家(ミドルウェア)
演出家(ミドルウェア)は、「役者(音素材)」に対して「主人公(観客)が近づいてきたら、段々声を大きくして話しかけて」「もし周りがうるさくなったら、声を張って(ダッキング)」「壁の裏に回ったら、ボソボソ声に変えて(フィルター)」という指示書(ルール)を書いて渡します。
そして舞台(ゲームエンジン)から「いま主人公が近づいたよ!」と合図(イベント)が来たら、演出家が即座に役者(音)に指示を出して演技させる、という位置付けです。
2. どこに挟まっているのか?(位置関係)
処理の全体像で見ると、ちょうど真ん中の「橋渡し役」として存在しています。
{音の素材制作}DAW (Pro Tools, Cubase等)
⇩
{ミドルウェア (Wwise, FMOD)
⇩
{空間・映像の統合}ゲームエンジン / ライブシステム}
⇩
最終出力{スピーカー / HMD}
3. なぜミドルウェアという「間(ミドル)」が必要なのか?
ミドルウェアを挟まないと、以下のような問題が発生します。
- ミドルウェアがない場合:「雨が降り始めたら音を鳴らす」「建物に入ったら雨音をこもらせる」という細かい計算ルールを、すべてプログラマーがゲームエンジンのコードとして書き直さなければなりません。
- ミドルウェアがある場合:サウンドエンジニアがミドルウェア上で「建物に入ったら音をこもらせる」というルール(プリセット)を直感的に作っておけます。ゲームエンジン側は「いま建物に入った」というスイッチ(信号)を1個押すだけで済むようになります。
つまり、ミドルウェアの位置付けとは「プログラミング知識がなくても、高度で複雑なインタラクティブ音響ルール(空間オーディオ処理・自動軽量化・ダッキング等)をサウンドデザイナー自身が視覚的に組み立てられる専門ツール」となります。
ゲームエンジンを使わなくても成立しますか
はい、ゲームエンジンを一切使わなくても空間オーディオのシステムは完全に成立します。
特に、ゲームのような「インタラクティブな3D空間(プレイヤーが自由に移動する等)」を必要としない用途では、ゲームエンジンを使わない構成の方が一般的かつ合理的です。
1. ゲームエンジンを使わない代表的なケース
- 映画・映像作品(Dolby Atmos / Sony 360 Reality Audio等)
- 映像のタイムラインに沿って音が移動するため、リアルタイムの3D空間処理(ゲームエンジン)は不要です。
- 構成: DAW(Pro ToolsやNuendo等)+ 空間オーディオプラグイン ⟶ オブジェクトベース/チャンネルベース出力
- 一般的なライブコンサート・ドーム音響(L-ISA / d&b Soundscape等)
- 会場内の音響演出は、ミキサーやDAWから「専用のハードウェア音響プロセッサー(L-ISAプロセッサー等)」へ音声データを送り、プロセッサー側でリアルタイムに各スピーカーへ音を割り振ります。
- 構成: DAW/デジタルミキサー ⟶ ライブ専用立体音響プロセッサー ⟶ 会場スピーカー
- 360度動画(YouTube 360 / VR映像)
- 全天球映像に合わせた環境音などは、球状の音響データ(Ambisonics)として映像ファイルに直接埋め込まれます。
- 構成: DAW(アンビソニックス編集) ⟶ 動画ファイルへエンコード ⟶ メディアプレイヤーで再生
2. ゲームエンジンが必要・不要の境界線
| 区分 | ゲームエンジンが**「不要」**なシステム | ゲームエンジンが**「必要」**なシステム |
|---|---|---|
| 特徴 | タイムライン(時間軸)が決まっている、または専用機材で補える | ユーザーや物体が「3D空間内を自由に移動・操作」する |
| 主な用途 | 映画、音楽アルバム、固定演出のライブ、商業施設の空間音響 | VR/ARアプリ、対戦型ゲーム、自由移動型のバーチャル展示 |
| 位置情報の取得 | DAWのオートメーション(時間変化)や専用センサーから直接指定 | ゲームエンジンの3D空間座標(X, Y, Z)から毎フレーム自動計算 |
まとめ
ゲームエンジンはあくまで「自由度の高い3D空間とリアルタイムな移動計算が必要な場合」の選択肢の1つに過ぎません。
「映画」「楽曲」「ライブ演出」「施設音響」といった空間オーディオ領域では、DAW(音楽制作ソフト)と専用のオーディオプロセッサーやミドルウェアを直結させることで、ゲームエンジンなしで完全に高度な空間音響システムを構築できます。
1. ゲームエンジンを使用するワークフロー(VR / AR / ゲーム等)
ユーザーの移動や選択によってリアルタイムで音が変化するインタラクティブ空間を作る場合のパイプラインです。
【 Phase 1: 設計・素材制作 】
  [要件定義] ─── (バジェット・ルール策定)
      │
  [DAW (Pro Tools等)] ─── (モノラル/アンビソニックス素材出力)
      │
      ▼
【 Phase 2: 演出・ルール設定 】
  [オーディオミドルウェア (Wwise / FMOD)]
      ├─ 3D空間パラメータ (距離減衰・リバーブ・遮蔽)
      └─ リソース制御 (優先度・仮想ボイス・LOD)
      │
      │ ◄── プラグイン連携 (座標・イベント・動的スケーリング)
      ▼
【 Phase 3: 空間・リアルタイム統合 】
  [ゲームエンジン (Unity / Unreal Engine)]
      ├─ 3D空間のプレイヤー/オブジェクトの座標管理 (X,Y,Z)
      └─ 出来事 (イベント) のフラグ通知
      │
      ▼
【 Phase 4: 出力 (レンダリング) 】
  [最終出力フォーマット]
      ├─ オブジェクトベース ───► プレイヤー・効果音 (位置情報付与)
      ├─ シーンベース    ───► 環境音 (Ambisonics)
      └─ チャンネルベース ───► BGM・UI音 (2.0/5.1ch)
2. ゲームエンジンを使わないワークフロー(映画 / ライブ / 360°動画等)
タイムライン(時間軸)が決まっている映像作品や、会場の専用機材で演出する場合のパイプラインです。
【 Phase 1: 音響デザイン 】
  [DAW (Pro Tools / Nuendo / Ableton等)]
      ├─ 音素材の編集・ミックス
      └─ 空間パンニング・オートメーション (時間軸による位置移動の設定)
      │
      ▼
【 Phase 2: 空間オーディオ処理 】
  [専用プロセッサー / 空間オーディオプラグイン]
      ├─ (映画/配信) Dolby Atmos / Sony 360RA レンダラー
      └─ (ライブ音響) L-ISA / d&b Soundscape 等のハードウェア
      │
      ▼
【 Phase 3: 出力 (レンダリング) 】
  [最終出力フォーマット]
      ├─ 映像・配信 ───► アトモスデータ / Ambisonics埋め込み動画
      └─ ライブ会場 ───► 会場スピーカーアレイ (多チャンネル)
図のポイント
- ミドルウェアの位置づけ: 「音の演出ルール」をあらかじめ設定しておく中間処理として機能します。
- ゲームエンジンの役割: ゲームエンジンありの場合、ミドルウェアに対して「いま誰がどこにいるか」という位置情報を毎フレーム送信する司令塔となります。
第3章:
ポストプロダクションとミキシング
Post-Production & Mixing
撮影・レンダリング・3D空間設計された音声やアセットは、ポストプロダクション(MA・ミキシング・クオリティ管理)の工程で、最終的な「イマーシブ・オーディオ作品」として完成します。
第1章では、人間が音の方向や距離、奥行きをどのように知覚するのか、そして音と空間との関係をどのように記述するのかを見てきました。第2章では、その空間記述をもとに、3D空間の中へ音源を配置し、距離や空気吸収などによって音を変化させるための設計を扱いました。第3章では、これらの要素をひとつの作品として成立させるためにどのような空間記述フォーマットを選び、どの音をどのようにミキシングし、映像と音の空間的な整合性をどのように確認するかを扱います。
イマーシブオーディオのミキシングでは、単純に「音を前後左右に配置する」だけでは十分ではありません。
どのような再生環境を想定するのか。音をチャンネルとして扱うのか、オブジェクトとして扱うのか、それとも空間全体の音場として扱うのか。どの音を空間の背景として広げ、どの音を特定の位置に配置するのか。そして、映像の中で見えている人物や物体の位置と、音として知覚される位置や距離をどのように整合させるのか。こうした判断の積み重ねによって、最終的な空間音響体験が形づくられます。
3D立体映像の編集においてL/Rの整合性を保つことが絶対条件であったように、音響のポストプロでは、ターゲットとなる視聴環境に合わせた「空間記述フォーマット」の正しい選択とコントロールがコンテンツ制作の中の重要なポイントになります。
本章では、まず制作目的と再生環境に応じた空間フォーマットの選択について整理します。次に、空間全体を支える環境音と、位置や動きを明確に持つ音源を組み合わせるハイブリッド・ミキシングについて考えます。最後に、3D映像と音響の空間的な関係を整え、作品全体の一貫性を確認する「デプスマッチングと品質管理(QA)」を扱います。
ここで重要なのは、イマーシブミキシングを「すべての音を3D化する作業」と考えないことです。
むしろ、
どの音に、どの程度の空間情報を与えるのかを設計し配分すること
が、イマーシブミキシングの本質です。
空間を広げる音と、位置を示す音。
動かす音と、動かさない音。
近くに感じさせる音と、遠くに感じさせる音。
それぞれの役割を整理しながら、作品全体としてひとつの空間を成立させていきます。
3-1:再生フォーマットの定義と選択(チャンネル・オブジェクト・シーン)
第1章では、立体音響における空間記述を、大きく「チャンネルベース」「オブジェクトベース」「シーンベース」の3つの考え方として整理しました。これらは互いに競合するものではなく、それぞれの特性を理解したうえで、目的や再生環境に応じて選択・組み合わせることが重要です。
① チャンネルベース(Channel-Based Audio)
- 特徴:
制作者が意図した通りのスピーカーから直接音が出力されるため、スピーカー配置や再生条件が管理された環境では、安定した再現性を得やすい方式です。
5.1chや7.1chはもともと「大勢の観客が入る映画館(シアター)」を前提に開発されたフォーマットです。そのため、設計思想の根本には「サービスエリア(スウィートスポット)をいかに広く確保するか」という目的があります。 - 構造:
5.1chや7.1ch、さらに天井スピーカーを加えた5.1.4chや7.1.4chのように、特定の物理的なスピーカー(チャンネル)の位置に対して音声を固定して割り当てる伝統的なサラウンド方式です。
空間における適応性
リスナーの視聴環境(部屋の形、スピーカーの数や位置)が制作スタジオと少しでも異なっていると、制作意図通りの精密な定位が再現できなくなります。また、リスナーが頭を動かす「ヘッドトラッキング(動的インタラクション)」の動きに対して、各スピーカーの音量を個別にリアルタイム補正して音場を固定することが幾何学的に極めて困難なため、HMD(ヘッドセット)型の環境には単体では向いていません。
5.1chや7.1chは、あくまでリスナーを取り囲む「水平方向(2次元平面)」のチャンネル配置を基本とするため、高さ方向の情報を標準的には持たず、上下方向を含む空間表現には別の拡張が必要になります。
また、制作する側にとって、ターゲットごとに別々の音声データを用意しなければならないという効率の悪さがあります。2ch用、5.1ch用、7.1ch用など、それぞれのスピーカー構成に最適化したミックス(マスターデータ)を個別に作る必要があり、制作コストやデータ容量を圧迫します。
② オブジェクトベース(Object-Based Audio)
- 特徴:
位置・大きさ・方向などの空間情報をメタデータとして音声と関連付け、再生時のレンダリングによって適切な出力信号へ変換する方式です。 ※(Size)という言葉の取り扱い(すべてのオブジェクトベース方式に共通する固定概念ではない?ただし分かりやすいが。) - 構造:
音声信号と、「空間上の3次元座標(X, Y, Zのメタデータ)」および「音源の広がり(Size)」を独立したオブジェクトとして分けて扱います。再生時には、その空間情報をもとに、実際の再生環境に合わせて音像をレンダリングします。この方式では、制作時に特定のスピーカーへ直接音を固定するのではなく、「この音は空間のどこに存在するのか」という情報を保持できます。 - そのため、ゲーム、XRなど、異なる再生環境への対応や、音源の移動・インタラクションを必要とするコンテンツと相性のよい方式です。
- 代表規格: Dolby Atmos(ドルビーアトモス)、360 Reality Audio(ソニー)。
空間おける正確な(安定した)定位感・移動感の相性
再生するデバイス(映画館の数十台のスピーカー、リビングのサウンドシステム、あるいはHMDと連動したイヤホン)の側が、自身のスピーカー配置や現在のヘッドトラッキングの角度に合わせて、その瞬間に最適なL/Rの音響信号をリアルタイムに逆計算(ローカル・レンダリング)して出力します。
これにより、デバイスを問わず、制作者が意図した通りの「正確な(安定した)定位感」と「縦横無尽な移動感」を可能にします。ただし、オブジェクトベースだからといって、すべての音を個別のオブジェクトとして扱うわけではありません。実際の制作では、チャンネルベース要素とオブジェクトを組み合わせる構成も一般的です。
③ シーンベース(Scene-Based Audio / アンビソニックス)
- 特徴:
特定のスピーカー位置(チャンネル)や個別の点源(オブジェクト)を扱うのではなく、「リスナーを取り囲む全天球の音場を、球面方向の音響情報として記述・再現する」アプローチです。
※ここでいう「球体」はイメージ上の表現であり、実際には球面調和関数などを用いて音場を数学的に表現します。 - 構造:
音響工学においてはその代表的な方式が「アンビソニックス(Ambisonics)」 と呼ばれる技術です。空間全体の音を「球面調和関数」という数式に分解して記録(Bフォーマット化)するため、スピーカーの配置に依存しません。 - シーンベースでは、個々の音源を独立したオブジェクトとして管理するのではなく、空間全体に形成される音場を記述し、再生時に目的のスピーカー配置やヘッドホン環境などへデコードします。
空間における環境変化への対応力
球体データをデコードする際、ユーザーの視線・首の向き(ヘッドトラッキングデータ)に合わせて「球体データ全体をリアルタイムに逆回転(マトリクス変換)」させることが極めて容易です。
この特性により、360°映像やVRなど、視聴者の向きが変化するコンテンツでは、空間全体の音場を扱えることが大きな利点になります。
イマーシブオーディオ3大空間フォーマットの特性比較 (なくす?)
| 比較項目 | チャンネルベース | オブジェクトベース | シーンベース(アンビソニックス) |
|---|---|---|---|
| データの管理方法 | 物理スピーカーチャンネルへの固定 | 音声 + 3次元座標(X,Y,Z)メタデータ | 天球空間全体の波面の数式記述(球体) |
| 主な代表規格 | 5.1ch、7.1ch、11.1ch(Auro-3D) | Dolby Atmos、360 Reality Audio | Ambisonics (1st〜3rd Order: B-Format) |
| 得意な音響表現 | 固定された劇場のBGM・重低音効果 | 特定のキャラクターの声・明確に動く足音 | 風、雨、都市の喧騒などの「包み込む環境音」 |
| ヘッドトラッキング適応 | 難しい(デバイス側での再計算が高負荷) | 非常に容易(オブジェクト座標を逆算) | 非常に容易(球体全体の回転マトリクス処理) |
| 最適なユースケース | 従来の2Dシネマ、キャリブレートされた劇場 | 空間コンピューティング(Vision Pro等)、3Dゲーム | 180°/360°実写VR動画、実地フィールド録音 |
(代替え修正案) 全部は変えないでいく
| 比較項目 | チャンネルベース | オブジェクトベース | シーンベース |
|---|---|---|---|
| 基本単位 | チャンネル | 音源+空間情報 | 音場 |
| 得意な表現 | 固定された再生環境 | 個々の音源の位置・移動 | 空間全体の環境 |
| 主な用途 | 映画・放送・設備 | 映画・ゲーム・XR等 | VR・360°・環境音等 |
| 強み | 再生系が明確 | 柔軟な配置 | 空間全体を扱いやすい |
| 注意点 | 再生環境への依存 | レンダリング設計が必要 | デコード・空間表現の設計が必要 |
3次元空間音声(3Dオーディオ)3大方式 総合比較表
| 比較項目 | チャンネルベース (Channel-based) | オブジェクトベース (Object-based) | シーンベース (Scene-based) |
|---|---|---|---|
| 根本的な思想 | スピーカー(出口)に音を固定する | 音源(物体)を3次元空間に配置する | 空間(場)の響きをまるごと録音・再現する |
| データの実体 | スピーカーの数だけの音声トラック (例: 5.1ch = 6トラック) | 音声データ + 位置情報のメタデータ (X, Y, Z座標) | 空間の方向成分を数学的に分解した信号 (アンビソニックスなど) |
| ヘリコプターの例 (後ろから前へ移動) | 各スピーカーの音量バランスを変化させて移動を「偽装」する。 | デジタル空間に飛行ルート(座標)を描き、バーチャルに「飛行」させる。 | 通過した空間の空気の揺れを、周囲の環境音ごと「丸ごと保存」する。 |
| 再生機器での処理 | 指定されたスピーカーへ音声をそのまま流す。 | リスナーのスピーカー数やイヤホン環境に合わせてリアルタイムに逆計算(レンダリング)する。 | リスナーの頭の向き(ヘッドトラッキング)に合わせて、空間全体を数学的に回転させる。 |
| 最大のメリット | ・制作環境や仕組みがシンプル ・制作者が意図した通りのスピーカーから音が鳴る | ・驚異的な定位感(音の位置の解像度) ・再生環境を問わない(デバイスフリー) | ・VRのヘッドトラッキングと相性が抜群 ・専用マイクで実空間を簡単に一発収録できる |
| 最大のデメリット | ・リスナーの部屋の配置がズレると立体感が崩壊する | ・再生機器のデータ処理負荷が高い ・群衆の声など複雑な環境音はデータが肥大化する | ・個々の音源(特定のセリフなど)を後からピンポイントで動かすのが難しい |
| 代表的な技術・規格 | Dolby Digital, 5.1ch, 7.1ch | Dolby Atmos, Sony 360 Reality Audio, DTS:X | Ambisonics (1次〜高次アンビソニックス) |
| 主な用途 | 従来の映画、地上波テレビ、CD | 現代の映画、空間オーディオ配信、ゲーム | VR(360度動画), 実空間のフィールドレコーディング |
「これを3DCGのレンダリング技術に例えるなら、オブジェクトベースが空間に点光源を配置する『直接照明』であるのに対し、シーンベースは壁や床の相互反射までを含めて空間全体の光のエネルギーを記録する『ラジオシティ(Radiosity)』や『グローバル・イルミネーション(GI)』に近い。
空間全体の音響的な『陰影』を丸ごと保存しているため、リスナーが視線を動かした際(ヘッドトラッキング時)の滑らかな音場変化は完璧である。一方で、CGにおいて一度GIをベイクした後に特定の物体だけを動かすのが難しいのと同様に、シーンベースも録音後に特定の音源だけを分離して操作することが困難という特性を持つ。」
3DCGと空間音響の概念 対応表
| 空間音響の方式 | 3DCGのレンダリングに例えると | どのような状態か? |
|---|---|---|
| オブジェクトベース | ローカル・イルミネーション (直接光・点光源の設定) | 3D空間の中に「光源(音源)」を配置し、その座標から光(音)が直接放射される。物体単体の位置は明確だが、空間全体の「照り返し(響き)」は計算しないと表現できない。 |
| シーンベース | ラジオシティ / GI (大域照明・環境光) | 壁や床の反射を含めた「空間全体の光のエネルギー分布(ライトフィールド)」をまるごと計算・記録する。どこを向いても、空間全体のシームレスな陰影(音場)が破綻なく再現される。 |
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
- クリエイターへ:
ポストプロのDAW(Pro Tools、Nuendo、Logic Proなど)でミキシングを行う際、まずは制作物のゴールを明確にしてください。「実写VR動画や実地録音の臨場感」がメインなら最初からタイムラインのマスターをアンビソニックス(シーンベース)に設定し、「3D CGアニメーションや空間アプリのオブジェクトの動き」を見せたいならDolby Atmos(オブジェクトベース)のベッド/オブジェクト構造を選択するのが、ワークフローを破綻させないための基本です。 - プロのミキシング・MAエンジニアへ:
現代の最高峰のイマーシブ・ポストプロでは、これら3つのフォーマットの「ハイブリッド・ミキシング」が世界標準となっています。
実際の制作では、チャンネルベース、オブジェクトベース、シーンベースの考え方を、作品の目的や再生環境に応じて組み合わせることがあります。
具体的には、ベースとなる空間の風や部屋鳴り(アンビエンス)を「シーンベース(アンビソニックス)」または「チャンネルベースのベッド(7.1.2ch)」で広く豊かに敷き詰めた上で、主役のセリフ、飛び出してくる飛び道具のエフェクト音(VFX同調音)を「オブジェクトベース」としてその上に重ね合わせ、独立した座標メタデータを持たせて縦横無尽に定位させます。 - システム開発者へ(次世代オーディオパイプラインの構築):
空間ビデオ(MV-HEVC形式など)やインタラクティブXRコンテンツの再生プレイヤー(アセットデコーダー)を設計する際は、バックエンドのオーディオパイプラインに、オブジェクトベースのメタデータパーサー(位置情報のリアルタイム読み込み)と、高次アンビソニックス(HOA: Higher-Order Ambisonics)のリアルタイム球体回転(Rotation)シェーダーを同時に走らせる必要があります。ユーザーの首の動き(IMUデータ)が入力された際、オブジェクトの点源マトリクスと、シーンの球面マトリクスへ同時にブロードキャストする並列スレッドを構築してください。これにより、時空の歪みを一切感じさせない究極の音響ポストプロ・再生インフラが完成します。
3-2:ハイブリッド・ミキシングの基本設計
実際のイマーシブコンテンツでは、ひとつの空間記述方式だけですべての音を表現する必要はありません。むしろ、空間全体を感じさせる音と特定の位置に存在する音を、それぞれ適した方法で扱うことが重要です。この考え方が、「ハイブリッド・ミキシング(Hybrid Mixing)」です
3-1で解説した空間記述フォーマットの特性を活かし、現代のイマーシブ・ポストプロ現場で実践されているのが、「シーンベース(アンビソニックス)」または「チャンネルベースのベッド」と、「オブジェクトベース」をタイムライン上で高度に融合させる『ハイブリッド・ミキシング(Hybrid Mixing)』のワークフローです。
すべての音源をオブジェクトとしてバラバラに配置すると、空間全体の「音の馴染み(空気感)」が失われ、逆にすべてをシーンベースでひとまとめにすると、ピンポイントな移動感がぼやけてしまいます。
本節では、空間のリアリティと演出のダイナミズムを両立させる、ハイブリッド・ミキシングの幾何学的・音響的な設計理論を解説します。
① ハイブリッド構造の2つのレイヤー設計
ミキシングを開始する際、DAW(Pro Tools、Nuendo、Logic Pro等)のタイムライン構造を、役割の異なる以下の2つの基本レイヤー(階層)に分離して設計します。
1. アンビエンス・レイヤー(空間の基底・包み込む音)
アンビエンス・レイヤーは、その場所全体の空気感や環境をつくる音の層です。たとえば、
風、雨、森の環境音、都市の雑踏、遠くの交通音、部屋やホールの残響
などが含まれます。これらは、必ずしも「この一点から鳴っている」と明確に指定する必要はありません。むしろ、空間全体を包み込むように配置することで、リスナーがその場所にいるという感覚を支えます。シーンベースやチャンネルベースのベッドなどは、このような空間の基底を構成するために利用できます。
- 役割: 空間全体の「空気感」「部屋鳴り」「環境音」を描写し、リスナーを世界観の中に優しく包み込みます。
- 採用フォーマット: シーンベース(アンビソニックス)、または チャンネルベースのベッド
(7.1.2ch等)。 - 音源アセット: 森の風のさわめき、雨の音、都市の遠くの喧騒、コンサートホールの豊潤な残響など、発音位置が1点に特定できず、空間全体に充満しているべき音をここに配置します。これにより、リスナーが首を動かした際(ヘッドトラッキング)、自分の周囲360度の環境音全体がシームレスかつ均一に追従・ピン留めされる「安定した基底空間」が完成します。
2. ディスクリート・レイヤー(点源・動的な主役の音)(位置を持つ主役の音)
一方、ディスクリート・レイヤーでは、特定の音源を空間上の位置と結び付けます。たとえば、
人物の声、車の走行音、足音、鳥の鳴き声、特定の効果音、空間を移動する物体の音
などです。これらは、音源の位置、距離、移動、広がりなどを調整することで、視聴者に「そこに何かが存在している」という感覚を与えます。音源自体は大きさを持ちません。広がらせたいときは、エンジニアが複数のチャンネルに音を分配して広がりを擬似的に作ります。
- 役割: 空間内の「特定のオブジェクトの実在感」を際立たせ、移動や接近によるダイナミックな演出を行います。
- 採用フォーマット: オブジェクトベース(Dolby Atmos、360 Reality Audio等の座標データ付与)。
- 音源アセット: キャラクターのセリフ、目の前をかすめる銃弾(VFX環境)、近づいてくる敵の足音、SF映画のUFOの飛行音など。「X, Y, Zの3次元空間座標」と
「Size(音源のサイズ・拡散率)」「音源の広がりを表す空間パラメータ」のメタデータを持たせることで、リスナーのすぐ耳元を通り抜けるような「ピンポイントな定位感」と「強烈な移動感」をデザインします。(大きさとしては持っていないことに注意)
② 重要なのは「全部を動かさない」こと
イマーシブミキシングでは、すべての音を動かしたくなる誘惑があります。しかし、空間内のすべての音が頻繁に移動すると、リスナーにとって空間の基準が失われてしまいます。そこで、
動かない空間をつくり、その中で必要な音だけを動かす
という考え方が重要になります。
背景となる環境音が空間を支え、その上で人物や物体の音が移動する。この関係によって、空間全体の安定感と、個々の音源の動きの両方を成立させることができます。
③ 2つのレイヤーを繋ぐ「空間のブレンドSize(または Spread / Diffusion)」の制御 音源の「広がり」を設計する
オブジェクトベースの制作では、音源の位置だけでなく、音像の広がりを調整できる場合があります。
一点に集中した音は、明確な位置を示します。
一方、音の広がりを大きくすると、空間の中により柔らかく溶け込ませることができます。
ここで重要なのは、「この音をどれくらい明確な位置として感じさせるのか」という、聴覚上の役割です。たとえば、人物のセリフは比較的明確な位置を持たせ、雨や風は広がりを持たせる。爆発音であれば、発生時には位置を明確にし、その後の残響や反射によって空間全体へ広がっていくように設計します。このように、音源の空間的な広がりそのものを演出パラメータとして扱うことができます。
ハイブリッド・ミキシングにおいて最も職人技(エンジニアリング・センス)が求められるのが、これら2つのレイヤーの境界線を自然に調和させるための「音源のサイズ(Size)および拡散率(Spread)」の動的パラメータ制御です。
オブジェクトベースのミキシングプラグイン(Dolby Atmos Pannerなど)には、座標(X,Y,Z)とは別に、「音の広がり」を設定する Size(または Spread / Diffusion)というプロパティが存在します。
音源の広がりを表すSizeやSpreadなどのパラメータは、音を「点音源」として鋭く定位させるのか、ある程度の広がりを持った「面音源」として表現するのかを調整するために用いられます。
※名称や値の範囲、アルゴリズムは制作システムによって異なるため、本書では特定の数値を標準値としては扱いません。あくまで参考値です。
- Size: 0%(完全な点源):点音源・ピンポイントな定位感
音は空間の「わずか1点」から針の先のように細く鋭く発音されます。キャラクターの囁き声や、ピンポイントな警告UI音に最適です。 - Size: 50% 〜 80%(面音源・グループ化):
音の座標を中心としつつも、周囲のスピーカーや空間全体(アンビエンス側)へと滑らかに音が滲み(にじみ)出すようにブレンドされます。
面音源(Plane Source / Surface Source)
グループ化「音源の肥大化・巨大化」「空間への拡散」 - Size: 100%(空間飽和):
オブジェクトとしての個別座標の性質を失い、リスナーを取り囲む全方位から均一に聴こえる状態(実質的なアンビエンス・レイヤーへの完全同化)になります。
「全方位音源」「全天周定位」
実務における演出例:トンネルへの進入(あくまでひとつの典型例)
車が疾走するシーンにおいて、車のエンジン音(オブジェクト)を [Size: 10% 程度で]ピンポイントに定位させておきます。車が急に「狭いトンネル」に入った瞬間、壁からの超近接反射音(レイトレースまたはリバーブエフェクト)を急激に立ち上げると同時に、エンジン音の[Sizeプロパティを動的に 70% へと拡張]音源の広がりも適切に変化させます。
これにより、音がトンネルの壁全体に乱反射して周囲から押し寄せてくるような「空間の容積の変化」を、ハイブリッドなミキシングトリックによってリアルに表現できます。
ハイブリッド・ミキシングの構造マップ
ハンドブックのセッション構成(テンプレート設計)のガイドラインとしてそのまま使用できる、アセットごとの配置・ミキシング基準です。(あくまで参考例)
| アセットの種類 | 適切なレイヤー配置 | 空間フォーマット | Size/Spread設定 | ミキシング時の注意点 |
|---|---|---|---|---|
| BGM・劇伴音楽 | アンビエンス・レイヤー | 7.1.2ch ベッド | 50%〜100%(包み込み) | ステレオの音楽素材は、天井(Height)チャンネルに20%〜30%程度音を滲ませることで、床面に定位するセリフとの帯域の衝突を防ぐ。 |
| 環境音(風・雨) | アンビエンス・レイヤー | 3rd Order アンビソニックス | 100% 固定 | 完全にリスナーを全天球で包む。ヘッドトラッキング時の回転マトリクス遅延(20ms以内)を厳密に管理する |
| 主役のセリフ | ディスクリート・レイヤー | オブジェクトベース | 0% 〜 15%(点源) | 3D映像の「主役の役者の顔の位置(ゼロ視差面)」の座標と完璧にシンクロさせる(デプスマッチング) |
| 爆発・エフェクト | ディスクリート・レイヤー | オブジェクトベース | 0%(発生時) ──> 80%(爆風拡散時)へ動的アニメーション | 発音した瞬間はピンポイントに、爆風が広がるにつれてSizeパラメータを広げ、アンビエンス(残響)レイヤーへ滑らかに逃がす。 |
※名称や値の範囲、アルゴリズムは制作システムによって異なるため、本書では特定の数値を標準値として扱いません。あくまで参考値です。
(変更代替え案)
| アセット | レイヤー | 空間的な扱い | 設計上のポイント |
|---|---|---|---|
| BGM・劇伴 | アンビエンス・レイヤー | 広がりを持たせる | セリフや効果音とのマスキングに注意 |
| 環境音 | アンビエンス・レイヤー | 空間全体を構成 | リスナーの移動・回転との整合性 |
| 主役のセリフ | ディスクリート・レイヤー | 明確な位置を与える | 映像上の人物位置との整合 |
| 爆発・エフェクト | ディスクリート+アンビエンス | 発生位置から空間へ拡張 | 直接音・反射・残響の時間変化 |
ハイブリッド・ミキシングの基本原則
ハイブリッド・ミキシングは、「空間全体を支える音」+「空間内で位置を持つ音」という二つの役割を組み合わせる考え方です。その目的は、すべての音を立体化することではありません。
空間の基準をつくり、その中で重要な音源の存在と動きを際立たせること。
これが、ハイブリッド・ミキシングの基本的な考え方です。
現場の全レイヤー(クリエイター・プロ・開発者)への実務アドバイス
- クリエイターへ:
ハイブリッド・ミキシングを始めるときは、タイムラインを「動かない背景音(アンビソニックス等)」のトラックと、「激しく動く主役の音(オブジェクト)」のトラックに色分けして整理してください。すべての音を動かそうとすると、リスナーはどこに注目(注耳)すればよいか分からなくなり、聴覚的な迷子(疲労)になってしまいます。背景を安定した空間として設計することで、重要なオブジェクトの移動や定位が際立ちます。 - すべての音を空間的に動かす必要はありません。背景を安定した空間として設計することで、重要なオブジェクトの移動や定位が際立ちます。
- プロのMA・サウンドデザイナーへ:
実務においては、Dolby Atmosの「LFE(低頻度効果音 / サブウーファーチャンネル)」の扱いに注意してください。オブジェクトベースの音声は、高音域の定位(HRTF/耳介フィルター)が優秀な反面、超低音(80Hz以下)は人間の耳の構造上、方向を特定できません。低域では高域に比べて方向感が得にくくなるため、重低音の扱いでは、定位だけでなく、再生システムやLFE、他の周波数成分との関係を含めて設計します。 そのため、重低音エフェクト(爆発の地響きなど)はオブジェクト単体に持たせるのではなく、チャンネルベースの「ベッドのLFEチャンネル(.1ch)」へとルーティング(分岐)して信号を送ることで、シアターやサウンドバーのサブウーファーのパワーを最大限に引き出すことができます。※※いらない- システム開発者へ(ハイブリッド・オーディオノードの最適化):
ゲームエンジンやXRアプリのランタイム内でハイブリッド・ミキシングシステムを実装する際、アンビエンス・レイヤー(シーンベース)のデコード処理と、ディスクリート・レイヤー(オブジェクトベース)のHRTF畳み込み処理を、オーディオDSP内部で別々のスレッド(または実行プライオリティ)に切り分けてください。
シーンベースの球体マトリクス回転は極めて低負荷な数式計算であるため、高頻度でトラッキングデータを反映させ、負荷の高いオブジェクトごとのレイトレースやHRTF計算は発音数に応じて動的にクランプする「非同期型ハイブリッド・オーディオパイプライン」を構築するとよいでしょう。これにより、システムの安全性を最優先しながら、高精細な立体音響空間を維持できます。
3-3:デプスマッチング ― 映像の視差(奥行き)と音響の距離感の空間的整合性
3D立体映像における「視差(Parallax)」がもたらす視覚的な深度と、イマーシブオーディオにおける「距離減衰」や「初期反射」がもたらす聴覚的な深度を1:1で完全に一致させる映像が示す位置・距離感と、音が示す方向・距離感をひとつの空間として矛盾なく知覚できるように調整する設計思想を「デプスマッチング(Depth Matching)」と呼びます。 [1, 2]
人間の脳は、視覚と聴覚のデプス(奥行き)がズレていると「見た目は手前にあるのに、音は奥から聴こえる」という空間知覚のバグ(認知矛盾)を検知し、空間的な違和感や没入感の低下につながる可能性があります。そのため、ポストプロの最終段階において、両者の深度を同期させる必要があります。 [1]
3D映像では、「視差(Parallax)」によって物体の前後関係や奥行きを知覚します。一方、音響では、音量、直接音と反射音の比率、残響、周波数特性、両耳間の時間差やレベル差など、複数の手掛かりから距離や位置を知覚します。そのため、映像と音響が同じ空間を扱う作品では、両者の空間的な情報が矛盾しないように設計することが重要になります。
これを本章では、「デプスマッチング(Depth Matching)」と呼びます。ただし、ここでいう「マッチング」は、映像の視差(奥行き)と音響の距離感を1対1の数値として一致させるという意味ではありません。
重要なのは、
映像が示している空間的位置と、音が示している空間的位置・距離感が、ひとつの世界として整合していること
です。
① 映像の奥行きと音響の距離手掛かり
たとえば、映像の中で人物がカメラの近くにいるにもかかわらず、その声が遠くから聞こえると、視覚と聴覚の情報に矛盾が生じます。逆に、遠くにいる人物の声を極端に近く、大きく、明瞭に再生すると、映像上の距離感と音響上の距離感が一致しません。
そこで、映像上の位置関係を確認しながら、
音源の位置、距離減衰、直接音と反射音のバランス、残響、空気吸収、音源の広がり
などを調整します。これらは単独で距離を決めるものではなく、複数の手掛かりを組み合わせて距離感を設計するための要素です。
② 近距離・中距離・遠距離の考え方
近距離の音では、直接音の明瞭さや定位の精度が重要になります。中距離では、直接音と環境音、反射音などのバランスが距離感に影響します。遠距離になると、音量の低下に加えて、高域の減衰や残響との関係が重要になってきます。ただし、これらを固定的な数値で決める必要はありません。作品のジャンル、音源の種類、再生環境、演出意図によって適切なバランスは変化します。
③ デプスマッチングのQA
最終的な確認では、映像と音を個別に評価するのではなく、両者を同時に体験したときに空間的な矛盾がないかを確認します。
チェックするポイントとしては、
- 画面上の人物と声の位置が一致しているか
- 物体の移動と音の移動が一致しているか
- 近づいてくる音が、映像上の接近と整合しているか
- 遠ざかる音が、距離感の変化を伴っているか
- 場所が変わったとき、音響空間も自然に変化しているか
- カットや場面転換によって、前の空間の残響が不自然に残っていないか
などがあります。
特に重要なのは、「音が正しいか」だけではなく、「映像と音を合わせたときにその世界(周囲)が正しく感じられるか」です。
① デプスマッチングの同期メカニズム
映像のピクセルズレと音の座標(距離)を数学的・システム的に同期させる手法は、制作環境(CGか実写か)によって使い分けられます。
1. 3D CG・ゲームエンジン環境(自動同期・システム制御)
3D CG(Blender、Mayaなど)やリアルタイムエンジン(Unity、Unreal Engine 5)においては、「映像の視差(奥行き)と音響の距離の同期」は常に考慮しなければならない事項です。3D空間上のCGオブジェクトと音源を同一の座標系で管理することで、映像と音の位置関係を連携しやすくなります。[1, 2]
- ロジック:
仮想空間内のキャラクター(3Dメッシュ)に対し、映像用の「カメラコンポーネント(一人称視点 / FPS / First-Person Shooter)」と、音響用の「オーディオ・エミッター(発音点ノード)」を同じ座標(X, Y, Z)にペアリング(親子化)して配置します。 - 仮想空間内のキャラクターやオブジェクトに対し、映像用のカメラ情報と音響用のオーディオ・エミッターを同じ座標系で関連付けて配置します。
- 効果:
キャラクターが画面手前へ飛び出す(負のパララックス)動きをすれば、カメラのレンズ計算が自動的に映像の左右ピクセルを外側へシフト(Disparityを拡張)させ、同時にオーディオエンジンがリスナーとの距離をリアルタイム逆算して音量を上げ、高音の空気吸収フィルターを解除します。これにより、プログラムレベルでのデプスマッチングが自動化されます。
2. 実写撮影・VFX環境(データ連携・手動マッチング)
実写の3Dカメラリグで撮影された素材の場合、映像のピクセルデータと音声が物理的に分離しているため、同期にはポストプロでのデータ連携が必要になります。
- ロジック:
撮影現場の「マッチムーブ(Matchmove)部門」や「Onset Data Wranglerオンセットデータラングラー」が記録した、カメラから被写体までの実際の物理距離(メタデータ)をVFX・MAチームが共有します。 [1] - 効果:
コンポジットソフト(Nukeなど)で解析された映像の「ディスパリティマップ(視差マップ)」のピクセル値をDAW(Pro Tools、Nuendoなど)にインポートし、音源オブジェクトの「Z軸(奥行き)」のオートメーションカーブとしてコンバート・適用します。これにより、実写映像の3Dの動きに音が吸い付くように同期します。
Onset Data Wranglerオンセットデータラングラー
現場の物理データを収集・記録します。 [1, 2, 3]
環境データの計測: レーザー距離計やメジャーを使い、カメラから被写体への距離、カメラの高さ、チルト(傾き)角などをテイクごとに記録します。 [1, 2, 3]
ライティング・カラー情報の収集: HDRI(360度ハイダイナミックレンジ画像)の撮影や、ミラーボール/グレーボール(CBGB)、カラーチャートの撮影を行い、現場の光の回り方や色温度をCG空間に再現するためのリファレンスを採取します。
② 映像レイヤーと音響パラメータの同期基準
デプスマッチングを行う際、エンジニアが基準とする「視差の符号」と「音響パラメータ」の連動設計です。
映像の視差情報は、音響パラメータを直接1対1で決めるものではありません。たとえば、映像上で対象が近く見える場合には、音量、直接音と残響音の比率、初期反射、周波数特性などを総合的に調整することで、映像と整合した距離感を作ります。反対に、遠くに見える対象では、距離減衰や直接音・残響音の比率、空気吸収などを組み合わせて距離感を設計します。
- 負のパララックス(画面手前への飛び出し) ──> 「直接音の最大化」
- ゼロ・パララックス(スクリーン面) ──> 「基準定位」
- 正のパララックス(スクリーンの奥の奥行き) ──> 「残響と空気吸収の連動」
③ ステレオオーディオQA(品質管理)のチェックリスト
マスター納品前に行う、映像と音の立体矛盾を検出するための最終QA基準です。
- ウィンドウ・バイオレーション時のミュート・Size制御
オブジェクトが画面の端に触れて立体感が崩壊する「ウィンドウ・バイオレーション」が発生したカットでは、音のピンポイントな定位(Size: 0%)を解除し、あえて環境音側(Size: 80%以上)に音を滲ませて引き込めることで、観客の意識を画面端のエラーから逸らす処理を行います。
音源の定位を少し広げる、あるいは環境音側へ馴染ませるなどして引き込めることで、観客の意識を画面端のエラーから逸らす処理を行います。 - 映像上の人物・物体と音源の位置関係が一致しているか。
- 移動する音源が、映像上の移動と矛盾していないか。
- 対象が接近・離脱するとき、音量、直接音、反射・残響、周波数特性などが不自然に変化していないか。
- カット(場面転換)時の残響テールのクランプ
映像が「狭い部屋」から「広い大草原」へパッと切り替わった(デプスカット)瞬間、前の部屋の残響音(リバーブ)の残響テールが新しいカットにダラダラと残っていると、視覚の切り替わりと聴覚の切り替わりが矛盾します。カットの瞬間に前のリバーブを急激にボリュームダック(クランプ)させるセーフティをMA時に必ず仕込んでください。
デプスマッチングの本質
デプスマッチングとは、映像の奥行きを音で数値的に再現することではありません。
映像と音、それぞれが持つ異なる空間手掛かりを組み合わせ、ひとつの空間として矛盾なく知覚できる状態をつくること
です。
奥行き(Perception)、距離(Distance)、視差(両眼視差Parallax)、あるいは両耳間差(interaural differences)による立体感(Spatial Depth)の整合性を保つこと
その意味で、デプスマッチングは単なる技術設定ではなく、映像と音を統合するための最終的な空間設計とQAの工程と考えることができます。
第4章:
音響ディスプレイと実空間インフラ
Auditory Display & Real Spaces
(空間)音響ディスプレイSpatial Auditory Display
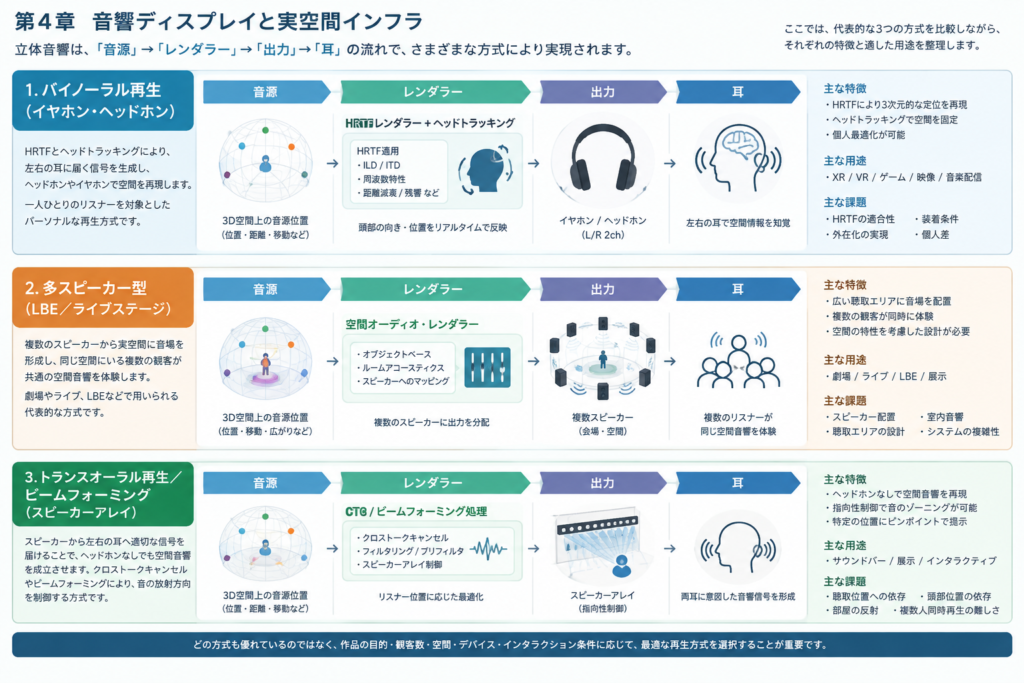
第3章までにポストプロダクションで完璧にミキシング・データ同期された3次元の空間音声も、最終的にリスナーに届ける「音響ディスプレイ(出力デバイス)」や出力環境に合わせなければその真価を充分に発揮できません。本章では、デプスマッチングされた音の設定データをどのように出力(アウトプット)するかを考えていきます。
個人向けのイヤホンやヘッドホン環境から、大人数が集まる大型ライブステージの音響インフラまで、立体音響を正しく出力するための実務とシステム実装を解説します。
「3次元空間音声(オブジェクトオーディオ)を完全に再現するためには、データ側の正確さだけでなく、それを受け止める『音響の実空間インフラ』の構築が不可欠です。このインフラは、正確なスピーカー配置(ハードウェア)、不要な反射を抑える室内音響(建築環境)、そして空間の歪みを正す音場補正(ソフトウェア)の3つが統合されることで初めて機能します。」
第3章までで設計‧ミキシングした空間⾳響は、最終的にどのような環境で、どのようなデバイスからリスナーに届けられるのでしょうか。⽴体⾳響では、⾳源の位置情報や距離感を正しく設計するだけでは⼗分ではありません。最終的な体験は、ヘッドホンやイヤホン、スピーカー、スピーカーアレイ、室内⾳響、ヘッドトラッキングなど、再⽣系全体の設計によって決まります。
第4章では、⽴体⾳響を実際の空間へ出⼒するための「⾳響ディスプレイ(Auditory Display)」に注⽬します。
⼤きく分けると、再⽣環境には次のような違いがあります。
- 個⼈向け再⽣:イヤホン‧ヘッドホンによるバイノーラル再⽣
- 多⼈数向け再⽣:LBE、劇場、ライブステージなどのマルチスピーカー再⽣
- 特殊なスピーカー再⽣:トランスオーラル、クロストークキャンセル、ビームフォーミングなど
同じ「空間⾳響」という⾔葉を使っていても、これらは⾳を届ける仕組みが⼤きく異なります。重要なのは、どの⽅式が優れているかではありません。
作品の⽬的、観客数、空間、デバイス、インタラクション条件に対して、どの再⽣⽅式を選択するか。
これが、イマーシブコンテンツにおける⾳響ディスプレイ設計の基本になります。
1. 現代のミキシング構造:「ベッド」と「オブジェクト」の統合
現代のポストプロ(例:Pro ToolsとDolby Atmos Rendererを使用する環境)では、ミキシング段階でチャンネルベースとオブジェクトベースが同じタイムライン上で共存しています。
- 土台(ベース)はチャンネルベース【Bed(ベッド)】
- 音楽(BGM)や、環境音(森のざわめき、街の喧騒、雨の音)など、空間全体を包み込む音は、まず「7.1ch」などのチャンネルベースのトラック(=ベッド)にルーティングします。スピーカーに音が固定されているため、空間の土台が安定します。
- 動き回る要素はオブジェクトベース【Object】
- ヘリコプターの爆音、飛び交う銃弾、画面を横切る車の音などは、ベッドとは切り離し、「音声 + 3D座標(メタデータ)」のオブジェクトトラックとして個別に扱います。
統合のレンダリング
ミキサー(制作者)は、安定した「ベッド(背景)」の中で、「オブジェクト(点音源)」を縦横無尽に動かしてミックスを完成させます。最終書き出し(マスターファイル)の段階で、これらは1つのファイル(例:.atmos)の中に統合され、再生機器側で合算されて出力されます。
2. 映像メディア(映画・配信)での3方式の統合ワークフロー
映画や配信コンテンツのポストプロでは、実録のリアルな響き(シーンベース)を取り込みつつ、最終的にオブジェクトベースへと統合していく流れが一般的です。
【収録・素材】
・実空間の環境音 ───> [シーンベース(アンビソニックス)] ──┐
・セリフ、効果音 ───> [モノラル / ステレオ素材] ───────┼─> 【統合ミキシング】
                                                            │     (Dolby Atmosなど)
【空間の響き】                                              │     ベッド + オブジェクト
・スタジオのリバーブ ─> [チャンネルベース(マルチch)] ────┘
- シーンベースによる「空気感」の取り込み:
ロケ地で4指向性マイク(Soundfieldマイクなど)を使い、その場の「シーンベース(アンビソニックス)」で環境音を丸ごと録音します。 - チャンネルベース(ベッド)へのデコード:
ポストプロのスタジオに持ち帰ったシーンベースのデータは、一度「7.1ch」などのチャンネルベース(ベッド)の環境音としてデコード(変換)され、ミックスの土台に据えられます。これによって、まるで現地にいるかのような「グローバル・イルミネーション(GI)」的なリアルな空間の響きが再現されます。 - オブジェクトの追加:
そのリアルな土台の上に、スタジオでクリアに録音されたセリフや、個別の効果音(オブジェクト)を重ね、3次元的に配置・移動させます。
3. インタラクティブメディア(VR・ゲーム)での統合ワークフロー
VRやゲーム(UnityやUnreal Engine、Wwise等を使用)のポストプロでは、リスナーの頭の動き(ヘッドトラッキング)にリアルタイムに追従させるため、最終出力が「シーンベース」や「バイノーラル」になるという逆の流れが起きます。
- オブジェクトとしてゲーム空間に配置:
敵の足音やアイテムの音を、3D CG空間内の「座標(オブジェクト)」として配置します。 - シーンベース(アンビソニックス)へのリアルタイム統合:
ゲームやVRが実行されると、システム内部のオーディオエンジンが、無数のオブジェクトの音と背景音をブレンドし、瞬時に「シーンベース(アンビソニックス)」の信号へとリアルタイムでミキシング(エンコード)します。 - ヘッドトラッキングへの追従:
プレイヤーが頭を動かすと、そのシーンベースの空間データ全体が高速で回転処理されます。 - 最終出力:
回転されたシーンベースの音が、最終的に2chのバイノーラル(イヤホン用)に翻訳され、リスナーの耳に届きます。
まとめ
「ポストプロダクションにおける空間音響ミキシングの本質は、これら3つの方式の『ハイブリッド運用』にあります。
映画制作では、実空間の響きを宿したシーンベース(アンビソニックス)の素材を、空間の土台であるチャンネルベース(ベッド)へと流し込み、その中を縦横無尽に駆け巡る点音源をオブジェクトベースとして重ね合わせます。デジタルデータの段階でこれら異なる音響方式を高度に統合することで、『立体的空間』を構築してます。」
4-1:イヤホン・ヘッドホンにおける空間オーディオ(バイノーラル再生とOS連携)
空間コンピューティングやモバイルXR、音楽ストリーミングサービスにおいて、最も多くのリスナーが立体音響を体験することが出来るデバイスが「イヤホン・ヘッドホン」の環境です。左右2つのスピーカーしかないこの極小のデバイスで、全天球(360度)の空間を疑似的に再現するための表示(出力)メカニズムを解説します。
① バイノーラル再生(Binaural Rendering)の仕組み
イヤホンやヘッドホンで立体音響を出力するコア技術が、「バイノーラルレンダリング(バイノーラル再生)」です。
第3章で制作した「オブジェクトベース」や「シーンベース」のマスター音声フォーマットを、リスナーが再生した瞬間に、再生デバイス側のオーディオエンジン(DSP)が、第1章で解説したHRTF等のフィルターを介し、最終的にリアルタイムに2ch(L/R)の信号へ変換(レンダリング)して出力します。
リスナーの耳には「普通のL/Rの音声」として届きますが、その波形にはILD(音量差)やITD(時間差)、耳介による空間的な手掛かりが含まれ、脳は「音源が頭外の空間に存在するよう」に感じます。これがバイノーラルの仕組みです。
② 主要OS(iOS / Android / visionOS)の空間音響トラッキング連携
現代の空間オーディオ(Spatial Audio)の実装において最も重要な要素のひとつなのが、イヤホン単体でレンダリングを完結させるのではなく、スマートフォンのOSやXRデバイスのヘッドトラッキングシステムとシステムレベルで深く連携させることです。
AirPods Pro(Apple)やPixel Buds(Google)などに内蔵されたIMU(ジャイロセンサー)が検出した頭の回転データは、各OSのオーディオレイヤーへと送られます。
- Apple(iOS / visionOS)の連携(AVFAudio / Spatial Audio API):
Appleの環境では、AVAudioEngine や PHASE(Physical Audio Spatialization Engine)
を通じて、対応デバイスのヘッドトラッキング情報を利用した空間オーディオを実装できます。
Apple Vision Proにおいては、ユーザーが空間内に配置したアプリのウィンドウ(画面)の位置と、そのアプリから発せられるオブジェクト音の座標をOSが常時リンクし、「画面を置いたその部屋の場所に、音の定位を固定するような」、空間コンピューティングに適応した動的インタラクションを実現しています。 - Androidの連携(Android 13以降のSpatializer API):
Android OSにおいても標準で空間音響APIが統合されており、対応するヘッドホンを接続することで、システムレベルでの動的なバイノーラル・ヘッドトラッキング再生が可能になっています。開発者は、UnityやUnreal EngineからOS標準の空間音響リソースに直接アクセスし、レンダリングを実行させることができます。
バイノーラル出力(HMD/スマホ)における設計チェックリスト
HMDやスマートフォン向けのイヤホン再生をターゲットに、コンテンツを書き出し・実装する際の安全基準です。
| 制御項目 | 推奨されるシステム・設計値 | 破綻した場合のリスク・症状 | 解決するためのコア技術 |
|---|---|---|---|
| Motion-to-Sound遅延 | 20ms程度以下 許容できる遅延はシステム構成や用途によって異なります | 頭の動きに対して音が遅れて追従し、VR酔いや脳の不快感を誘発 | オーディオバッファの最小化(128 samples以下)、高優先度スレッド化 |
| L/R位相の整合性 | 逆相(Out of Phase)の完全排除 | 左右の波形が打ち消し合い、立体定位が中央に潰れる | 位相チェッカーによるQA、マルチビューデコーダーの同期 |
| パーソナライズ | 個人HRTFの利用/HRTFデータの適用 | 空間が広がらず、頭の芯の中に音が閉じこもる(頭内定位) | Apple/Sony等のOS標準耳スキャンAPIとのアセット連携 |
③現場の全レイヤー(初心者・プロ・開発者)への実装アドバイス
- 初心者クリエイターへ:
自分で制作した空間オーディオ(Dolby Atmos等)の作品をYouTubeやApple Musicへ配信する際は、「視聴者が必ずイヤホン(またはヘッドホン)で聴く」という前提のディスクレイマー(注記)を動画の冒頭や概要欄に入れてください。バイノーラル音声は、スマホのスピーカーからそのまま鳴らしてしまうと、左右の耳に光の混色のように音が混ざり合ってしまい、せっかくデザインした立体感がなくなってしまいます。 - プロのサウンドデザイナー・カラリストへ:
MA(マルチオーディオ)スタジオでスピーカー(7.1.4chなど)を使ってミックスを仕上げた後、必ず「ターゲットとなるデバイス(例:iPhone + AirPods Pro)にマスターデータを転送し、実際にイヤホンで聴きながら首を振って最終チェック(QA)」を行ってください。スピーカー環境では自然に聴こえていた残響(リバーブ)が、バイノーラル(イヤホン)変換された途端に不自然に強調されて不快に聴こえるケース(バイノーラル過剰効果)が多々あるため、イヤホン向けの最終微調整(マスターEQの補正)がプロの実務では必須です。 - システム開発者へ(OSネイティブ空間音響の呼び出し):
クロスプラットフォーム(iOS/Android両対応)のXRアプリをUnity等で記述する際は、独自の重いHRTF畳み込みプラグインをアプリに内蔵(ビルド)するのではなく、可能な限り Google Resonance Audio や Appleの Apple Spatial Audio プラグインなど、OSがハードウェア(チップ)レベルで最適化して用意している「ネイティブ空間音響SDK」を動的に呼び出すアーキテクチャを採用してください。これにより、オーディオ処理によるCPU負荷とレイテンシーを抑え、映像・トラッキング・音響処理の同期を安定させます。
代表的な空間オーディオ・プラットフォーム(Dolby Atmos / 360 Reality Audio / Vision Pro)
ポストプロダクションで制作されたオブジェクトベースの立体音響データは、主要なプラットフォーム・ハードウェアのエコシステムを通じて、リスナーの耳元(バイノーラル環境)へと届けられます。それぞれの技術的な位置づけと、クリエイターが把握すべき実装の特徴を解説します。
(1) Dolby Atmos(ドルビーアトモス)──【映画・音楽のグローバル・スタンダード】
- 技術的位置づけ:
映画業界から生まれ、現在ではApple MusicやAmazon Musicなどの音楽ストリーミング、Netflixなどの動画配信プラットフォーム、そして最新のゲーム(Xbox/PC)までを網羅する、オブジェクトベース音響の規格です。 - クリエイター・開発者のための特徴(ベッドとオブジェクトのハイブリッド構造):
Dolby AtmosはチャンネルベースのBedとObjectを組み合わせる方式で、用途やワークフローに応じてBed構成やObject数が異なります。最大128チャンネルの音声トラックを同時に扱えます。そのうち「10チャンネル」を固定の環境音(7.1.2chのベッドトラック)として敷き詰め、残りの「118チャンネル」を空間を縦横無尽に動き回る「音声オブジェクト(3次元座標メタデータ付き)」として自由に配置・パンニングする構造を持っています。映画館からスマホのイヤホンまで、あらゆる再生環境への互換性(スケーラビリティ)が高いのが最大の強みです。
(2) 360 Reality Audio──【ソニーが提唱する「全天球・音楽没入」技術】
- 技術的位置づけ:
ソニーが開発した、国際標準規格「MPEG-H 3D Audio」をベースとする音楽・ライブ体験に特化したオブジェクトベースの立体音響テクノロジーです。 - クリエイター・開発者のための特徴(完全な全天球オブジェクト構造):
Dolby Atmosが「映画館(四角い部屋と天井)」をベースに設計されているのに対し、360 Reality Audioは「リスナーを中心とした完全な天球(球体空間)」としてオブジェクトベースで空間を記述します。
最大128個の音声オブジェクトを、全方位(13画のスピーカー配置などを模した球体座標)にピンポイントでマッピング可能。最大の特徴は、前述の「SOFA規格/耳スキャンデータのパーソナライズ」との親和性が極めて高く、ソニー製の対応ヘッドホンと連携することで、ヘッドホン特有の「頭の中に音が閉じこもる(頭内定位)」を最も劇的に排除できる、音楽ミキシングにおいて極めてシャープなエッジを持った規格です。
(3) Apple Vision Proの「空間オーディオ(Spatial Audio)」──【空間コンピューティングのためのハード・ソフト融合】
- 技術的位置づけ:
Apple Vision Pro本体の耳元に搭載された左右2基の「デュアルドライバー・オーディオポッド」と、OS(visionOS)がハードウェア・ソフトウェアの次元で完全融合した、空間コンピューティングのための最先端の音響ディスプレイシステムです。 - クリエイター・開発者のための特徴(オーディオ・レイトレーシングとビジュアル同期):
Vision Proのサウンドシステムは、単にDolby Atmosなどの映画音響を高精度に再生・ヘッドトラッキングするだけではありません。本体のセンサーが「ユーザーの部屋の壁の材質や家具の配置(空間のアコースティック形状)」をリアルタイムにスキャンします。
これにより、ユーザーが部屋の「右奥の壁際」に配置した映画のウィンドウ(画面)や3D CGオブジェクトの音は、実際にその壁で跳ね返ったかのような、その部屋の物理特性に最適化された残響(オーディオ・レイトレーシング)を自動合成して発音されます。
さらに、内蔵のアイトラッキングと超低遅延なIMU(Motion-to-Sound遅延20ms以内)により、首を振っても音源が完全にその部屋の場所に「ピン留め」され、現実の音と仮想の音が完全に境界線を失う「音響的拡張現実(Acoustic AR)」を世界で初めてOSレベルでコマーシャル(商用)実装した、未来の音響インフラの手本です。
3大空間音響エコシステムの仕様・実装比較
| システム名 | 主な開発元 | データ記述の思想 | 最適なクリエイティブ領域 | 開発者・クリエイターのメリット |
|---|---|---|---|---|
| Dolby Atmos | Dolby Laboratories (アメリカ) | 7.1.2chベッド + 最大118個の動的オブジェクト | 商業映画、配信ドラマ、ゲーム、大手音楽配信の全般。 | 上映館や対応サウンドバー(シネマインフラ)への圧倒的な普及率と互換性。 |
| 360 Reality Audio | ソニー(日本) | MPEG-Hベース、最大128個の全天球完全オブジェクト | 音楽ライブ映像、ASMR、ボイスドラマ、音楽配信。 | スマホアプリと連動した個人用HRTF(SOFA耳スキャン)による、 |
| Apple Vision Pro (Spatial Audio) | Apple(アメリカ) | visionOS内蔵、物理空間スキャン連動型オブジェクト | 空間アプリ(XR)、Apple Immersive Video(8K/180°) | オーディオ・レイトレーシングの自動実行。現実の部屋の壁とデジタル音響の完全融合 |
4-2:リアル物理空間(LBE / ライブステージ)への実装(d&b Soundscape、YAMAHA Sound xR Imageの実績)
3D立体音響のテクノロジーは、イヤホンやヘッドホンを着用した閉じた個人環境(バイノーラル)だけでなく、「同じ物理空間に多くの観客が集まり、HMDを付けずに裸眼(生耳)で立体音響を共有する」ロケーションベース・エンターテインメント(LBE)や大型ライブステージのインフラをも大きく変革しています。
現実の広い空間において、従来のL/R(ステレオ)スピーカー配置の限界を打ち破り超え、完璧な3D空間定位を実現する最先端のハードウェア・システムの実績を解説します。
ヘッドホン
音源 → HRTF → 両耳
LBE・ライブステージ
音源 → レンダラー → 複数スピーカー → 物理空間 → 両耳
この違いを図にする
① 従来のライブPA(ステレオ)の限界と「スイートスポット」の消失
長年、コンサートや劇場などのライブエンターテインメントでは、ステージの左右(L/R)に巨大なスピーカーを吊り下げる方式が標準でした。
従来のステレオ方式ライブステージの課題点
- スイートスポットの極端な狭さ:
左右のスピーカーから出る音量と時間のバランスが完全に一致し、正しい立体(ステレオ)定位を感じられる場所(スイートスポット)は、客席の「中央のわずか一握りの座席」「どうしても中央付近」に限られていました。 定位の破綻(右側の席の観客は、左側のステージにいる演者の声も、目の前の右スピーカーから聴こえてしまう):
客席の左側に座る観客には左スピーカーの音が、右側に座る観客には右スピーカーの音が大きく先に届くため(ILD/ITDの強制狂い)、ステージ上の実際のアーティストの位置(視覚)と、音が聴こえてくる方向(聴覚)が激しく矛盾しの差が出て、イマーシブな没入感が損なわれていました。
② 世界のイマーシブサウンドの標準:d&b Soundscape
この物理空間の音響的な壁を打破し克服し、次世代ライブオーディオの標準代表的なイマーシブライブサウンドシステムの一つとなったのが、ドイツの高級音響メーカーd&b audiotechnik社が開発したオブジェクトベースのイマーシブサウンドシステム「d&b Soundscape(サウンドスケープ)」です。
- 仕組みとアプローチ(スピーカーアレイとDS100プロセッサー):
ステージ上部や客席の周囲を囲むように、数台〜数十台のスピーカーを等間隔で横一列に配置(スピーカーアレイ化)変則的なレイアウトにもArrayCalc(シミュレーションソフト)を通じて柔軟に対応します。
心臓部となるシグナルプロセッサー「DS100」が、ミキシング段階で指定された各音声アセットの3次元空間座標(X, Y, Z)のメタデータをリアルタイムに解析。すべてのスピーカーから、それぞれの位置から音源までの距離(ディレイ)と音量をマトリクス計算し、高度な波面合成(Wave Field Synthesis)の理論に基づいて音の波を物理空間に射出音場(おんじょう)を再現するします。 - 国内の実績:日本初の常設ホール「SGCホール有明」
- 実績: 東京・有明に、世界最大級の「d&b Soundscape」を常設した日本初の多目的ホール「SGCホール有明」が誕生しました。この劇場では、客席の最前列から最後列、さらに上手(右端)や下手(左端)の座席に至るまで、「会場にいるすべての観客が、ステージ上の役者や楽器のある『その1点(ピンポイント)』から正確に音が聴こえてくる」という、スイートスポットが客席全体に拡張された究極のリアル空間立体音響を実現しています。
③ 中小規模空間の民主化:YAMAHA「Sound xR Image」
大型スタジアムや高価な専用ホールだけでなく、既存のクラブや中小規模のライブハウス、イベント展示スペースに対しても手軽に高品質なオブジェクトベース音響を導入・民主化することを目指し、開発されたのが日本のヤマハ(YAMAHA)株式会社による立体音響ソリューション『Sound xR Image(サウンド・エックスアール・イメージ)』です。
- 仕組みと特徴:
ヤマハが長年培ってきたデジタルミキサーのプロセッシング技術と、独自の音場創成技術(AFC: Active Field Control)を応用。大がかりなスピーカーの常設工事や専門の音響設計士によるシミュレーションを行わなくても、機材パッケージを配置するだけで、その空間の特性をシステムが自動計測。中小規模のパフォーマンス空間において、演者の動きに合わせた滑らかな動的オブジェクトベース定位(イマーシブオーディオ)を低コストでレンダリング・出力することができます。 - 実証実験の実績:
- 実績: ヤマハは中小規模のライブパフォーマンスにおける音響体験の革新、およびアーティストの新しい表現手法の拡張を目指し、音楽イベントや常設アミューズメント施設での実証実験を急加速させています。これにより、商業展示(LBE)のポップアップストアや小規模シアターでも、映像の3Dの飛び出しやメタバース空間とリアルな音が完璧に融合するインタラクティブ空間を容易に構築できるようになりました。
リアル物理空間(LBE)向け立体音響システムの特性比較
| システム名 | 開発メーカー | 主要な再生方式(ロジック) | メインターゲット環境 | 導入・運用の最大の実績・価値 |
|---|---|---|---|---|
| d&b Soundscape | d&b audiotechnik (ドイツ) | 高精度オブジェクトベース (波面合成マトリクス演算) | 大型ホール、アリーナ、常設劇場、メガフェス。 | SGCホール有明 への常設。客席全体のすべての座席を「スイートスポット」化する。 |
| Sound xR Image | ヤマハ株式会社 (日本) | オブジェクトベース + AFC音場制御 (中小規模最適化・パッケージ化) | ライブハウス、展示会、ポップアップ、XRアトラクション。 | 全国のエンタメ施設での実証実験。立体音響インフラの「低コスト化と民主化」を牽引。 |
現場の全レイヤー(クリエイター・プロ・開発者)への実務アドバイス
- クリエイターへ(イベント出展など):
展示会などで自分の3D作品(映像+立体音響)をリアルなブースで展示する場合、イヤホンを配る(バイノーラル)のか、スピーカーから直接鳴らす(物理空間)のかを初期に決定してください。もしスピーカーから鳴らす場合は、Sound xR Image のようなオブジェクトベースのミキシングを行っておくことで、現場のスピーカーの配置が急遽変更になっても、ソフトウェア側のスピーカー座標プロパティを書き換えるだけで一瞬で完璧な立体感が再レンダリングされ、現場でのトラブルを防ぐことができます。 - プロのPA・音響システムエンジニアへ:
d&b Soundscape などのスピーカーアレイ環境を設定する際は、第3章で記述した「デプスマッチング(映像の Parallax と音の Distance の同期)」が何メートル先を基準に作られているかをVFX・映像チームと綿密に共有してください。ステージ最前面に設置された大型LEDディスプレイから3Dグラフィックスが飛び出す瞬間、DS100プロセッサー側のオブジェクト座標(Z軸)のオートメーションをマイナス(客席側)へと動的に増大させることで、現実の空気をも震わせる完璧な視聴覚シンクロ演出が可能になります。 - システム開発者へ(LBE向けインタラクティブ音響の実装):
リアル空間のLBEシステム( Sandbox VR や STYLY の空間展示プロジェクトなど)にこれらの物理立体音響インフラを統合する際は、トラッキングシステム(OptiTrack / Ti-Max Tracker / BlackTrax等)が検出した役者やプレイヤーのリアルな位置情報(座標)を、OSC(Open Sound Control)通信プロトコル経由で DS100 等のハードウェアプロセッサーへ直接、ブロードキャストするネットワークスクリプトを記述してください。これにより、仮想世界のモンスターの咆哮やCGの爆風が、物理空間のスピーカーアレイから実体を持った音波として観客に届くMR(複合現実)音響インフラが完成します。
4-3:トランスオーラル再生とスピーカーアレイ技術(イヤホンなしでの空間オーディオ)
第4章の締めくくりとして、イヤホンやヘッドホンを着用する「バイノーラル再生(4-1)」でもなく、多人数向けの巨大な「スピーカーアレイ空間(4-2)」でもない、「リスナーは何も身につけていない(肉眼・生耳)状態であるにもかかわらず、目の前にある少数のスピーカーから『自分の真横や真後ろ』にピンポイントな立体音響を届ける」というアプローチを解説します。
これは、3D立体視における「メガネの要らない裸眼立体ディスプレイ(Looking Glass等)」のような音響工学の最先端ディスプレイ技術です。
① トランスオーラル再生(Transaural Audio)とクロストークキャンセルのロジック
トランスオーラル再生とは、元々はヘッドホン向けに設計された立体音響信号(バイノーラル音声)を、「2基のスピーカー(または1本のサウンドバー)を使って空気中に放射し、リスナーの耳元に直接届ける技術」を指します。
物理スピーカーでバイノーラルを鳴らした際の致命的な問題(クロストーク)
1-1で解説した通り、3Dオーディオの基本は「右耳用の音」と「左耳用の音」を完全に分離して鼓膜に届けることです。しかし、目の前にある右のスピーカーから音を鳴らすと、その音は空気中を伝わって「左の耳」にも届いてしまいます。この現象を音響工学で「クロストーク(Crosstalk / 混信)」と呼びます。
クロストークが発生すると、脳のための立体手がかり(ILD/ITD)がすべて空気中で混ざり合って相殺され、立体感が完全に失われてしまいます。
解決策:クロストークキャンセル(Crosstalk Cancellation / CTC)
トランスオーラル再生の心臓部となるのが、この混信を物理的に打ち消す「クロストークキャンセル(CTC)」のアルゴリズムです。
- 仕組み:
右スピーカーから「右耳用の音」を出す際、システムは左耳に届いてしまう不要な回り込み音(クロストーク)をリアルタイムに予測。その光を打ち消す「逆位相(アンチフェーズ)」の音波を、左スピーカーから全く同じタイミングで同時に射出します(ノイズキャンセリングヘッドホンと全く同じ物理現象を、空気中の空間で実行します)。 - 左スピーカーから右耳へ届いてしまう音、右スピーカーから左耳へ届いてしまう音という「クロストーク」を、逆特性を持つフィルタリング/プリコーディングによって補償し、左右の耳に意図した信号を届けようとする技術
- 効果:
リスナーの左耳の直前で、右スピーカーからの回り込み音が物理的に相殺されて「消滅」します。結果として、リスナーはイヤホンを付けていないにもかかわらず、「右耳には右スピーカーの音だけ」「左耳には左スピーカーの音だけ」が純粋に届くという擬似的なヘッドホン環境が空気中に創り出され、音が自分の真横や後ろから回り込んで聴こえるようになります。
② 指向性スピーカー(ビームフォーミング)技術との融合
トランスオーラル再生の「スイートスポット(立体感が成立する位置)」を広げ、さらに強烈な定位を作るために組み合わされるのが、音をレーザー光線のように細く絞って特定の場所へ狙い撃ちする「ビームフォーミング(Beamforming / 指向性スピーカー)」の技術です。
- 超音波スピーカー(パラメトリックスピーカー):
人間の耳には聴こえない超音波に音声を乗せて発音します。超音波は直進性が極めて高いため、ビルの壁面や特定のスポット(床)に当たって初めて、そこから音が跳ね返って(発音源化して)聴こえます。 - スピーカーアレイによる動的トラッキング:
小さなスピーカー素子を横一列に何十個も並べ、それぞれの発音タイミングを数マイクロ秒単位でズラす(フェーズドアレイ駆動)ことで、物理的に動くことのない1本のサウンドバーから、「右耳へ向かう音のビーム」と「左耳へ向かう音のビーム」の2本を物理的に分離して射出します。
裸眼3Dディスプレイが視聴者の目の位置(アイトラッキング)をカメラで追うように、現代の最先端サウンドバーでは、搭載されたカメラや赤外線センサーがリスナーの頭の位置を動的にトラッキング。リスナーがソファーの上で左右に動いても、音のビームの角度をリアルタイムに物理・デジタル追従させ、常に完璧なクロストークキャンセル(CTC)を維持するシステムへと進化しています。
③ 代表的な製品・テクノロジーの実績
このトランスオーラル/ビームフォーミング技術を商業化・実用化しているトップランナーの事例です。
1. ヤマハ(YAMAHA):「デジタル・サウンド・プロジェクター(YSP)」シリーズ
- 実績と技術:
日本のヤマハが家庭用ホームシアター市場で一世を風靡し、今なお特許とノウハウを持つビームフォーミングスピーカーの先駆者です。1本のボディに最大40個以上の小型スピーカー(インテリジェント・アレイ)を内蔵。部屋の壁や天井の物理的な形状をマイクで自動計測(キャリブレーション)し、「音を壁に文字通り反射させて、観客の真後ろから音が跳ね返って聴こえさせる」という、リアルの物理反射をハッキングしたトランスオーラル環境を一般家庭に定着させました。
2. 裸眼3Dディスプレイとの統合ソリューション(Sony / Looking Glass環境)
- 実績と技術:
ソニーの空間再現ディスプレイ(Spatial Reality Display)や、Looking Glassのプロトタイプ展示において、このトランスオーラル・サウンドバーがディスプレイの下部にシステムレベルで統合・同期される実績が増えています。
視聴者がメガネなしで「画面から飛び出す立体3D CG」を見ている時、その瞳孔トラッキングデータ(アイトラッキング)の座標をそのままCTC(クロストークキャンセル)エンジンへ共有。「映像のオブジェクトが手前に飛び出す(負のパララックス)動きと1:1でシンクロし、音のビームの焦点もリスナーの耳元へと急接近する」という、デバイスを一切身につけない『完全素肌(肉眼・生耳)』での究極のイマーシブ・デプスマッチングが、次世代のハイエンドショールームや医療・産業シミュレータの展示インフラとして導入され始めています。
音響ディスプレイ(出力デバイス)の最終比較マップ
第4章の総括として、コンテンツの納品・ターゲット環境を網羅する比較データです。
| 比較項目 | バイノーラル再生(イヤホン) | スピーカーアレイ(大空間) | トランスオーラル再生(裸眼3D連携) |
|---|---|---|---|
| 身体的拘束 | イヤホン・ヘッドホンの着用が必要 | 完全に自由(生耳) | 完全に自由(生耳) |
| 立体音響の仕組み | デジタルHRTFフィルター畳み込み | 物理スピーカーへの座標マルチマッピング | 空間でのクロストークキャンセル + ビーム制御 |
| スイートスポット | リスナー本人の耳(頭の移動に自動追従) | 客席全体へ拡張(Soundscape等の効果) | カメラによる頭部トラッキングの範囲内(個人向け) |
| 映像方式との相性 | HMD(Apple Vision Pro, Meta Quest等) | 映画館、大型LEDステージ、LBEライブ | 裸眼立体ディスプレイ(Looking Glass等) |
現場の全レイヤー(クリエイター・プロ・開発者)への実装アドバイス
クリエイターへ:
トランスオーラル(サウンドバー環境)を想定した音作りであっても、DAW上でのミキシングの基本は「オブジェクトベース(Dolby Atmos)」のままで問題ありません。Dolby Atmos形式で書き出しておけば、視聴者のリビングにある対応サウンドバー(SonosやBose、Sony製など)が、自身のCTC・ビームフォーミング回路を使って自動でトランスオーラル再生へとコンバートしてくれるため、フォーマットの互換性を心配する必要はありません。
プロの展示デザイナー・設営技師へ:
商業施設や美術館の展示(LBE)で「イヤホンは配りたくないが、特定のブースの前に入った人にだけ3Dオーディオを聴かせたい」というシーンでは、超音波スピーカー(指向性スピーカー)を天井に垂直下向きに設置し、床面を反射板にする設計が極めて有効です。スポットライトを浴びるように、その直径1mのエリアに入った観客の耳元にだけピンポイントな立体音響空間が出現し、一歩外に出ると完全に音が消えるという、ゾーニング(空間隔離)演出が可能になります。
システム開発者へ(アイトラッキング共有パイプラインの構築):
裸眼3Dディスプレイとトランスオーラルサウンドバーを組み合わせた統合システムをC++やUnityで実装する際、グラフィックス側のカメラコンポーネントが取得しているユーザーの顔の3次元座標(Eye_Position_XYZ)を、ネットワークソケット(UDP/OSC)を介してサウンドバー側のCTCフィルタ制御モジュールへ直接、タイムスタンプのズレ10ms以内で常時ストリーミング(横流し)するブリッジシステムを記述してください。
頭のわずかな横ブレに対して、逆位相波の射出タイミングを完全に追従(フェーズ調整)させることで、トランスオーラルの最大の弱点であった「少し動くと立体感が一瞬でフラットなステレオに戻ってしまう」というバグを完全に克服した、最高峰の『完全裸眼・生耳型空間コンピューティングブース』を構築できます。
第5章:
次世代イマーシブ音響と今後の展望
Future of Acoustic Computing
従来の3Dオーディオは、「あらかじめスタジオで固定されたスピーカー配置(チャンネルベース)」や、「再生環境に依存する2つの視点(バイノーラル)」という枠組みに縛られていました。
しかし、空間コンピューティング(Spatial Computing)の到来とAI・リアルタイムシミュレーション技術の進化は、音響の世界も「再生(Playback)」のフェーズから、環境そのものをシミュレートする「音響コンピューティング(Acoustic Computing)」のフェーズへと引き上げつつあります。
本章では、音響設計の最先端トレンドと、本書の総括としての今後の展望を解説します。
5-1:ボリュメトリックオーディオと空間記述の未来
次世代のイマーシブ環境では、音響もまたグラフィックスと同じ空間情報を扱いながら、従来の「音声ファイルを再生する」という考え方から、「空間そのものを記述・生成する方向」へ進化しつつあります。この流れは映像の世界と同じ方向に向かっていると言えます。そのことを踏まえた上で少し未来のことを話してみます。
① ボリュメトリックオーディオ(Volumetric Audio)の可能性
第5章の立体視編で解説した「ボリュメトリックビデオ(Volumetric Video / 3D空間キャプチャ)」は、被写体を完全な3Dオブジェクト(メッシュや点群データ)として記録する技術です。
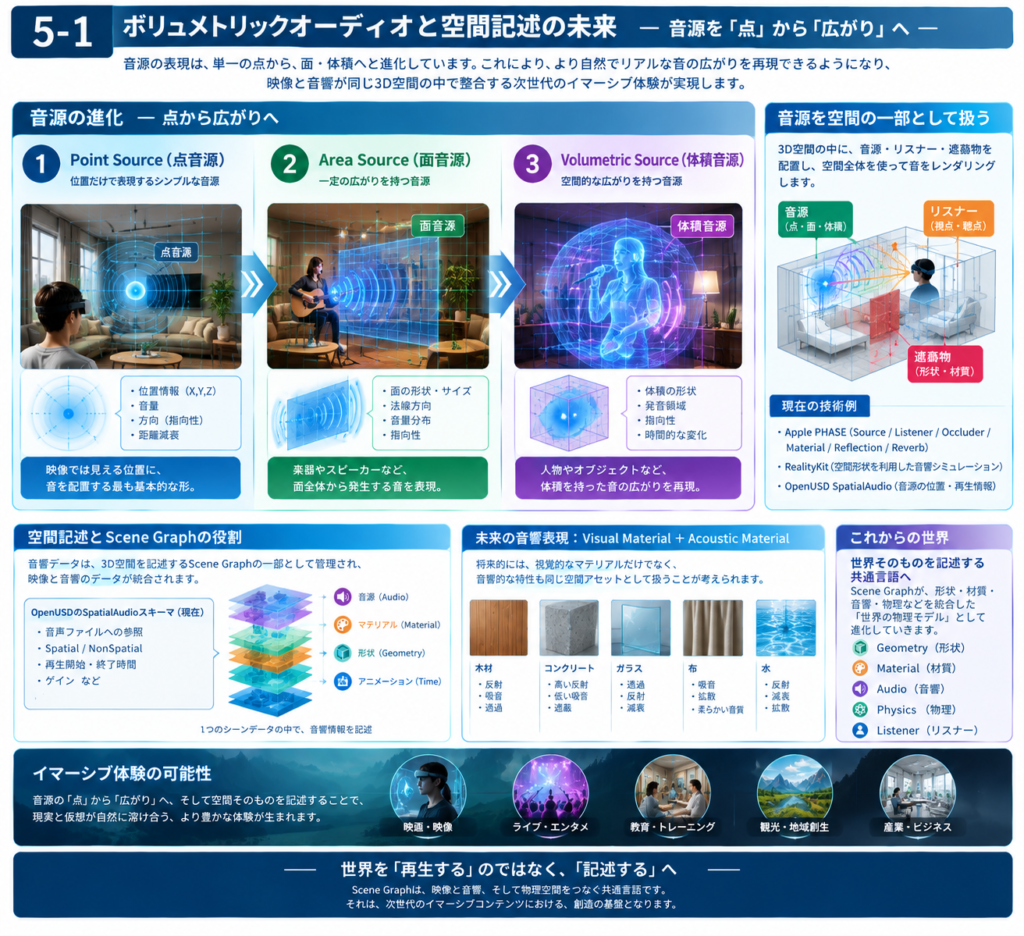
音響においても、音源を単一の「点」として扱うだけではなく、面や体積、指向性などの広がりを持った存在として記述・再現する考え方があります。本章では、こうした方向性を「ボリュメトリックオーディオ(Volumetric Audio)」と呼びます。
- 概念とロジック:
オブジェクトベースでは、音源を空間上の位置や動きなどのメタデータとともに扱い、再生時にレンダリングします。その音源モデルは、単純な点音源だけでなく、広がりや指向性を持ったモデルとして設計することもできます。
将来的には、音源を単一の点(オブジェクト)として扱うのではなく、音源そのものが持つ大きさ、形状、指向性、振動面などを含めて空間的に記述し、その状態に応じて音響を生成・レンダリングする方向へ発展していく可能性があります。
たとえば、3Dキャプチャされた人物や物体と音響情報を結びつけることができれば、「どこに音があるか」だけでなく、「どの部分から、どの方向へ、どのような広がりを持って音が発生しているか」を扱えるようになるのです。 - 体験の価値:
体験者が仮想空間内を自分の足で歩き回り(自由視点 / 6DoF)、被写体に「極限まで耳を近づける」ようなインタラクションを行った際、声が口元だけでなく、体全体の衣服の擦れや空間の反響を巻き込んだ「リアルな音」として変化します。これにより、VR/MR内での「実在感(プレゼンス)」が飛躍的に向上します。 - ➱体験者が仮想空間内を歩き回り、音源に近づいたり離れたりすると、音の大きさだけでなく、直接音と反射音の比率、遮蔽、指向性などが変化します。さらに将来的には、音源そのものが持つ「広がり」や「発音位置」を空間的に扱うことで、6DoF環境におけるプレゼンスをさらに高められる可能性があります。
② 空間記述フォーマット(Scene Graph)への完全統合
これからの音響設計において、オーディオデータは単独のファイルとして独立して存在するのではなく、3D空間全体の構造を記述する「シーン・グラフ(Scene Graph)」の一部として統合する方向へ進んでいます
- ➱Pixar、Apple、NVIDIAなどが主導する3D CG標準フォーマットである「OpenUSD」ではすでにSpatialAudioという仕組みが用意され、3Dシーンの中に音響再生情報を記述することができます。今後は、音源の位置だけでなく、遮蔽、反射、吸音、指向性など、より多くの音響情報をシーン記述と結びつけて扱う方向が期待されます。
- 開発の効率化:
将来的には、3Dマテリアルの記述と音響特性を結びつけることで、視覚的な「素材」と音響的な「素材」を共通の空間データとして扱える可能性があります。
今後は、3Dシーンに含まれる形状やマテリアル情報を音響エンジンが参照し、遮蔽・反射・回折・残響などの計算に利用するワークフローが、より一般化していくと考えられます。その先には、映像制作側が設定した空間情報を、音響側でも共通利用できる「音と映像の空間データ統合」があります。
これからの空間音響では、「音をどこに置くか」だけではなく、「音が存在する空間そのものを、どのように記述するか」が重要になる。
そして、
映像が3D空間を記述するように、音響もまた3D空間の中で記述される。
(まとめとして)
これまでの章では、音源の位置、距離、方向、反射、遮蔽、そして再生環境に応じて音をレンダリングする方法を扱ってきました。次の段階では、音源だけでなく、音源が存在する3D空間そのものをデータとして扱うことが重要になります。
映像では、人物や物体を3D空間内の形状・位置・動きとして扱う「ボリュメトリックビデオ」や3Dシーン技術が発展しています。音響においても、音を単一の点として扱うだけではなく、大きさ、形状、指向性、発音領域などを含めて空間的に記述する方向へ発展しつつあります。
ここでは、現在すでに利用できる技術と、そこから先に考えられる未来像を分けて整理します。
① 現在技術:音源を「点」から「広がり」へ
現在の空間オーディオでは、音源を3D空間上の位置とともに扱い、再生時にレンダリングすることが一般的です。ただし、音源は必ずしも「1点」から音が出るわけではありません。
たとえば、人の声は口の周辺から発生し、楽器や機械は一定の大きさを持った発音面を持っています。そのため、音源を点音源だけでなく、面積や体積を持った音源としてモデル化することができます。
実際にAppleのPHASEでは、点として音を発するPHASESourceに加え、3D形状を指定して面積・体積を持った音源として扱うことができます。音源とリスナーの位置関係に応じて距離減衰や指向性などを計算することも可能です。
これは、空間音響が単に
「音をどこに置くか」
だけではなく、
「音がどのような形で存在しているか」
まで扱えるようになっていることを示しています。
② 現在技術:音響と3Dシーンの連携
さらに重要なのが、音源と3Dシーンを別々に管理するのではなく、同じ空間情報を共有するという考え方です。Apple PHASEでは、音源、リスナー、遮蔽物などを3Dシーン内のオブジェクトとして扱うことができます。シーンの形状を利用して音源の遮蔽を計算したり、反射音や残響などの環境効果を加えたりすることもできます。
つまり、
3D空間 → 音響処理
という関係が、すでに実装レベルで成立しています。
たとえば、仮想空間内を体験者が歩き回れば、音源との距離だけでなく、間にある壁や空間の形状によって聞こえ方を変化させることができます。
この考え方は、6DoFによるイマーシブ体験と特に相性がよいものです。
③ 現在技術:Scene Graphに音響情報を記述する
3D空間をデータとして扱うための仕組みとして、Scene Graphがあります。代表的な3Dシーン記述技術のひとつであるOpenUSDには、すでにSpatialAudioスキーマが用意されています。
SpatialAudioでは、音声ファイルへの参照、空間再生か非空間再生か、再生開始・終了時間、ゲインなどをUSD Stageの中に記述できます。また、音源を3Dオブジェクトの階層下に配置することで、そのオブジェクトの移動と音源を連動させることもできます。
これは、音響データが単独の音声ファイルとして存在するだけでなく、「3Dシーンの中に存在する音」として扱えることを意味します。
ただし、ここで注意したいのは、OpenUSDのSpatialAudioが現在、吸音率や反射率、空気吸収などの音響物理特性をすべて標準化しているわけではないという点です。現時点では、シーン記述と音響レンダリングエンジンが連携するための基盤の一部が整いつつあると捉えるのが適切です。
④ 未来像:音源を「広がりを持った存在」として記述する
ここから先は、現在の技術をさらに拡張した未来像です。将来的には、音源を単純な点や再生位置だけではなく、
- 大きさ
- 形状
- 発音領域
- 指向性
- 振動面
- 時間的な変化
などを含めた空間的な存在として記述することが考えられます。たとえば、3Dキャプチャされた人物と音響情報を結びつけることができれば、「この人物の声がここにある」だけでなく、
「どの部分から、どの方向へ、どの程度の広がりを持って音が発生しているか」
という情報まで扱える可能性があります。
これが、ボリュメトリックオーディオを考えるうえでの重要な方向性のひとつです。
⑤ 未来像:映像と音響の共通空間データ
さらに先では、映像と音響を別々のデータとして制作するのではなく、ひとつの3D空間情報から両方を生成するワークフローが考えられます。たとえば、
3D形状
+
位置・姿勢
+
マテリアル情報
+
音源情報
+
音響パラメータ
を共通のScene Graphで管理するという考え方です。映像側では、そのデータからライティングやレンダリングを行います。
音響側では、同じ空間情報を利用して、遮蔽、反射、残響、距離減衰などを計算します。
すでに現在の空間オーディオ技術では、3D形状やマテリアルを音響処理に利用する仕組みが存在します。AppleのPHASEでは、遮蔽物の形状や物理マテリアルを音響処理に利用でき、RealityKitでも環境のジオメトリを利用した音響シミュレーションが実装されています。
将来的には、このような仕組みが特定のエンジンやプラットフォームだけでなく、制作パイプライン全体で共有できる空間データへ発展していく可能性があります。
⑥ 未来像:「音声ファイル」から「音響空間」へ
こうした流れをまとめると、空間音響の進化は次のように捉えることができます。
Point 音源を1点として配置する
↓
Object
音源を位置・方向・大きさなどの属性を持つオブジェクトとして扱う
↓
Scene
音源と3D空間を共通のシーン情報として扱う
↓
Environment
空間の形状、素材、遮蔽、反射、残響まで含めて音響を生成する
この先にあるのは、
「音声ファイルを再生する」のではなく、「空間を記述し、その空間から音を生成する」
という考え方です。これは、イマーシブコンテンツにおける音響設計の大きな転換点になる可能性があります。
映像が3D空間を記述するように、音響もまた3D空間の中に記述される。
そして最終的には、映像と音響が同じ空間データを共有し、それぞれのレンダラーがその空間を視覚と聴覚へ変換する。それが、次世代のイマーシブコンテンツにおける空間記述のひとつの方向性です。
5-2:空間コンピューティングにおける完全な現実・仮想音響の融合(Scene Graphと空間記述の未来)
空間コンピューティング(Spatial Computing)が目指す一つの到達点は、単にヘッドセット(HMD)を装着したユーザーに、デジタルな音を「再生」することではありません。現実の空間に存在する音響環境と、デジタルオブジェクトが発する音源を、同じ3D空間の中で整合させること。つまり、「現実の空間」と「仮想の空間」を、視覚だけでなく聴覚でも連続した一つの世界として成立させることです。ここでは、この考え方を「音響的AR=音響的拡張現実(Acoustic Augmented Reality)」と呼びます。
そのためには、音声ファイルそのものだけではなく、
- どこに音源があるのか
- どの方向を向いているのか
- どこにリスナーがいるのか
- 何が音を遮っているのか
- 壁や床はどのような形状なのか
- どのような音響特性を持つ素材なのか
- 音がどのように反射・減衰するのか
といった情報を、空間そのもののデータとして扱う必要があります。ここで重要になるのが、3D空間を構造化して記述する「Scene Graph(シーン・グラフ)」です。
① 現在技術:現実空間の3D情報を音響計算に利用する
空間コンピューティングでは、ステレオカメラや深度センサー(LiDAR)などによって、周囲の空間形状や物体の位置を認識し、その情報を3D空間モデルとして利用することができます。
このとき重要なのは、3D空間の情報が「映像を表示するためだけのデータ」ではなく、音響を計算するためのデータにもなりつつあることです。たとえばAppleのPHASEでは、3D空間の中に、「Source(音源)」「Listener(リスナー)」「Occluder(遮蔽物)」を配置し、それぞれの位置や形状を音響処理に利用できます。音源とリスナーの間に壁などの遮蔽物が存在すれば、その形状やマテリアル情報に応じて音の伝達を変化させることができます。また、反射や残響などの環境音響も空間情報と連動して処理できます。つまり、「映像のための3D空間」から「音響のための3D空間」へ。3D Sceneそのものが、音響レンダリングの入力データになり始めています。さらに現在では、音源を一点から発生するPoint Sourceだけでなく、形状を持ったArea / Volumetric Sourceとして扱うことも可能になっています。
最新の空間オーディオエンジンは、このスキャンされた形状データをグラフィックスの配置(オクルージョン)だけでなく、「音の反射計算」へ同時に流用します。
- 物理空間に応じた残響の動的補正:
ユーザーが「家具の少ないコンクリート打ちっぱなしの広い部屋」にいる時、デバイスの環境スキャナーは自動的にその空間の音響特性(長い残響時間)を計測。仮想空間から出現したデジタルキャラクターの声に対して、現実の部屋の壁の配置から逆算された「本物の跳ね返り音(リアルタイム・レイトレース反射)」を動的に付加して発音させます。 - 体験の価値:
リスナーが「絨毯が敷かれた狭い吸音室」へ移動すれば、キャラクターの声も自動的にデッド(響かない音)へと変化します。これにより、耳から入る情報(聴覚)が、現在自分が立っている物理空間のリアリティとシンクロし、「そこに本当に実在する」という強烈な実体感(プレゼンス)を生み出します。
② 空間記述フォーマット(OpenUSD / glTF)への音響メタデータ完全統合
これからのイマーシブコンテンツ制作において、オーディオ(音声ファイル)はグラフィックスと分離された独立したデータとしては存在しなくなります。Pixar、Apple、NVIDIA、Adobeなどが主導する3Dの国際標準記述フォーマット「OpenUSD(Universal Scene Description)」や「glTF」の進化により、映像と音は1つの「空間データ」として完全統合されます。
- マテリアルと音響物理特性の一体化:
USD等のシーン・グラフ(Scene Graph)内において、ある3Dオブジェクト(例:木製のドア)が定義される際、そのデータには形状やテクスチャの美しさだけでなく、「木材としての音響吸音率・反射周波数・遮蔽(シャープネス)の減衰率」といった音響物理特性のメタデータがあらかじめ1つのパッケージとして包括的に記述されます。 - 自動同期インフラの構築:
クリエイターやゲーム開発者が3D空間にアセットを配置した瞬間、オーディオエンジニアが手動で個別にフィルターを設定しなくても、システム(OS)側の共通レイヤーがその材質データを読み込み、第2章で解説した「レイトレース方式(音線シミュレーション)」をバックグラウンドで自動実行します。
これにより、キャラクターが木の扉の奥に隠れた(オクルージョン)瞬間、自動的に高音がこもり、音が回り込んで聴こえる「回折(Diffraction)」の幾何学的処理がプログラミングなしで美しく同期されます。
空間記述フォーマット(Scene Graph)による未来の統合マップ
ハンドブックの総括として、これからの空間開発者が把握すべき「映像・音響・物理特性」のデータ統合の構造モデルです。
| 空間アセット | 視覚データ(グラフィックス) | 聴覚データ(オーディオオブジェクト) | 空間記述に埋め込まれる物理メタデータ | 空間コンピュータ上での動的挙動 |
|---|---|---|---|---|
| コンクリートの壁 | 3Dメッシュ、高精細4Kテクスチャ | なし(反射体として機能) | 吸音率: 0.02(ほぼ全反射) 高域反射特性: High | 音源から出たレイトレース音線(Ray)を激しく跳ね返し、自動で硬く冷たい残響(リバーブ)を生成する |
| バーチャル演者 | ボリュメトリックビデオ(点群/3DGS) | ボリュメトリックオーディオ(体積源) | 発音座標、指向性(画角)、最小/最大距離(Min/Max) | 演者の口元や身体の形状表面から立体的な波面を射出。移動や飛び出しに合わせ、視差(Parallax)と音量が完全自動同期する |
| ガラスの窓 | 透過マテリアル、反射・屈折シェーダー | なし(遮蔽体として機能) | 音響透過損失(TL値): 25dB 低域透過率: Low | 窓が閉まっている時は奥の環境音(車の騒音等)の高域を25dB自動カットして遮蔽し、窓が開いた瞬間に直接音(Dry)を100%解放する |
最新動向と、立体音響における位置付けのロードマップを解説
1. OpenUSD(Universal Scene Description):制作現場を繋ぐ3D共通インフラ
Pixarが開発し、現在はAppleやNVIDIAなどが参画する団体「AOUSD (Alliance for OpenUSD)」によって標準化が進められているフォーマットです。 [1, 2]
立体音響における最新動向:Spatial Audio スキーマの策定
OpenUSDには、3D空間内に音源オブジェクトを配置するための標準スキーマ(定義データ構造)であるUsdMediaSpatialAudioが組み込まれています。 [1, 2]
- 特徴: 音源ファイルへのパス、3D空間内の位置情報(トランスフォーム)、再生タイミング、そして「立体音響(Spatial)として扱うか、環境音(Ambient)として一様に鳴らすか」といったメタデータを保持できます。 [1, 2, 3]
- 産業への普及とISO規格化: 2025年12月に標準仕様となる「Core Specification 1.0」が発表され、2026年現在、国際標準化機構(ISO)へのラティフィケーション(批准)に向けた手続きが進んでいます。これにより、エンタメ業界だけでなく、防衛、ロボティクス、自動車産業などのデジタルツイン(物理シミュレーション)で、音響空間を共通言語として扱う動きが決定定的になりました。 [1, 2, 3]
- Appleエコシステムでの深耕: AppleはWWDC 2026にて、新たなSwiftフレームワーク「USDKit」を発表しました。これにより、Apple Vision Proをはじめとする空間コンピューティングアプリで、OpenUSDベースの視覚・音響シーングラフをより軽量かつネイティブに実装・編集できるようになっています。 [1]
2. MPEG-H 3D Audio:インタラクティブ配信・放送の国際標準
フラウンホーファーIIS(Fraunhofer IIS)などが主導し、国際標準化団体MPEGが策定した配信・放送向けの次世代オーディオコーデック(ISO/IEC 23008-3)です。 [1, 2, 3]
立体音響における最新動向:視聴者が操作するシーングラフ
MPEG-Hの最大の特徴は、「Metadata Audio Elements(MAE)」と呼ばれるメタデータ(シーングラフの一種)を音声ストリームそのものに内包している点にあります。 [1]
- 視聴者側のインタラクティブ性: MAEのおかげで、受信側(テレビやイヤホン)で「実況解説の音量だけを上げる」「スタジアムの歓声を後ろに下げる」「副音声の言語を切り替える」といったシーングラフの動的変更が、再生プレイヤー側で可能になります。 [1, 2]
- 3DoF+(自由度の拡張)への進化: 従来のMPEG-Hは「頭の向き(回転)」に応じた3DoFの立体音響が中心でしたが、特許トレンドや技術文書からは、[2026年現在「ユーザーの移動(平行移動)」にも追従する**3DoF+への拡張実装が進んでいます。これにより、VR空間を歩き回るようなメタバース環境への最適化が強化されています。 [1]
- 制作から配信の一気通貫: 従来の放送局向け機材だけでなく、Digital Audio Workstation(DAW)プラグイン(Spatial Audio Designerなど)から直接MPEG-H対応の.mp4やマスターファイルを書き出せるエンコーダが普及し、個人のクリエイターでもMPEG-H形式のシーングラフを含んだコンテンツ制作が容易になっています。 [1]
3. OpenUSDとMPEG-Hの役割比較
この2つの規格は競合するものではなく、3D音響コンテンツのライフサイクルにおいて「制作(OpenUSD)」と「配信(MPEG-H)」という形で強固な補完関係にあります。 [1, 2]
項目 OpenUSD (Universal Scene Description) MPEG-H 3D Audio 主な役割 3D空間データの制作・編集・統合 配信・放送・最終レンダリング 音響アプローチ 3Dオブジェクト(メッシュやマテリアル)と同列で音源オブジェクトを「配置」する チャンネル、オブジェクト、HOA(アンビソニックス)を統合した「伝送・圧縮」 データの位置 3Dモデルファイルやシーンの階層構造( .usd)に紐付く音声ビットストリーム(パックされたパケット内)にメタデータとして同梱 主な推進者 Pixar、NVIDIA、Apple、Adobe、Autodesk Fraunhofer IIS、Qualcomm、Samsung、各国の放送局
今後の展望(まとめ)
今後は、「OpenUSDで構築された複雑な3Dゲームや映画のシーン(音響シーングラフ含む)を、リアルタイムにMPEG-Hのインタラクティブなビットストリームに変換してエンドユーザーに配信する」といったパイプラインのシームレス化が進んでいきます。これらが融合することで、あらゆるデバイスで一貫した、かつ視聴者が自由にカスタマイズできる立体音響体験が当たり前のインフラになっていくと予想されます。
(概念としては分かりやすい。)未来図としてこれを提示するか?
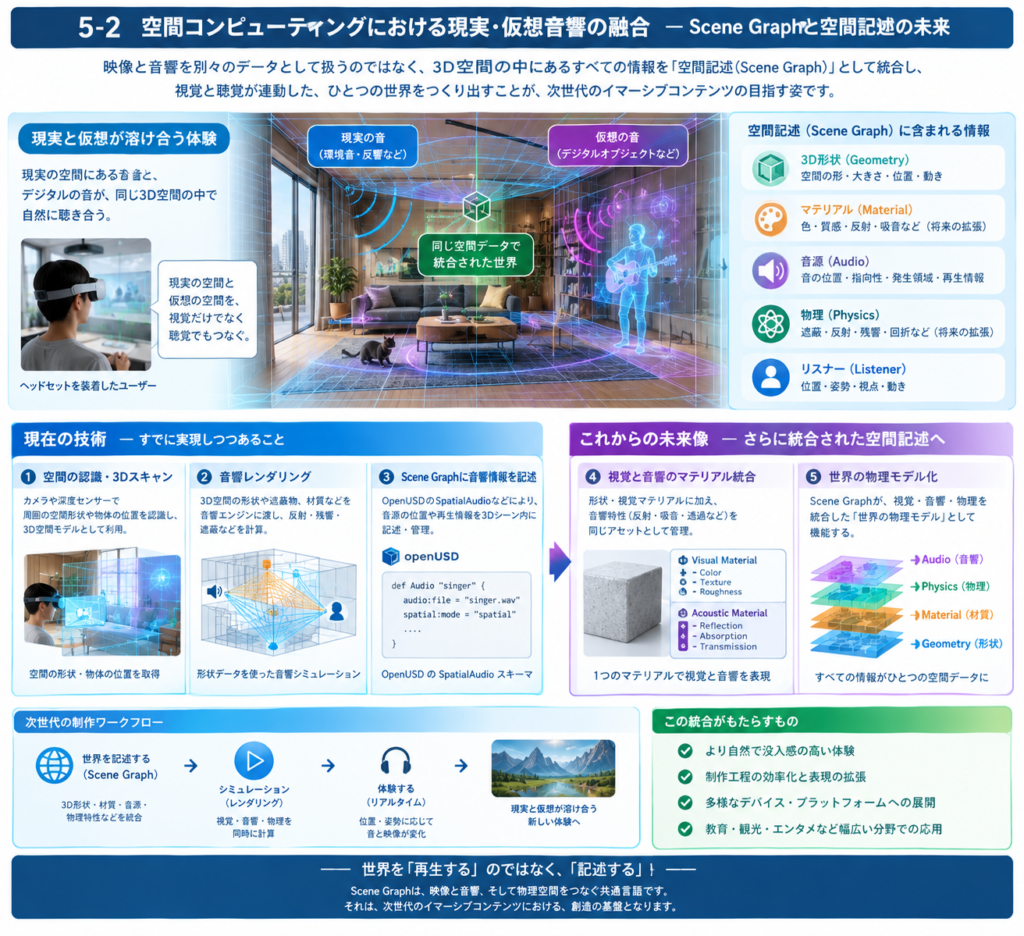
終章:
現場の開発者・未来の空間クリエイターへの提言
本セクションでは、人間の眼と耳の生体メカニズム(調節と輻輳、ILD/ITD/耳介フィルター)のハッキングから出発し、映像の「視差(Parallax/Disparity)」と音の「空間座標(Distance)」の完全な調和、そしてリアル空間(LBE)や最先端デバイス(HMD・3D LED)への実装にいたるまで、イマーシブコンテンツ制作のルールを体系的に網羅してきました。
これからの空間コンピューティング時代を生きるクリエイター、エンジニア、そして開発者の皆様へ、本書の総括として以下の3つの普遍的なメッセージを贈ります。
- 視覚と聴覚の「完全なる対等性(シンクロニシティ)」
イマーシブコンテンツにおける音(Audio)は、映像の「オマケ(BGM)」では決してありません。人間の脳は、映像の3D表現が完璧であっても、音が2Dプレーンに張り付いていた瞬間にその空間を「偽物」だと判定します。映像のデプス(Depth Budget)を設計する時に、音のデプス(Acoustic Budget)も同時にデザインするという、映像と音の不可視の空間設計を常に持つことが大切です。 - 生体工学(Human Factors)へのリスペクト
どれほど過激で魅力的なVFXやサウンドデザインであっても、人間の身体的限界を無視した設計は、観客に「苦痛・酔い・眼精疲労」を与えるだけのものになります。テクノロジーの力で人間の脳を心地よくするためには、常に人間の生体工学に対するセーフティ(限界値管理)を施すことが必要になります。 - 技術の民主化を武器に、未踏のイマーシブ表現へ
MV-HEVCやSOFA規格のような世界標準フォーマットの整備、さまざまなイマーシブ開発環境のオープンソース化、リアルな空間音響インフラの進化は、立体視・立体音響に代表されるイマーシブ技術を、個人クリエイターでも制作が可能なレベルへとブレイクダウンさせました。
映画館の四角いフレームから解き放たれ、都市の壁面、VRの全天球、そして私たちのリビングそのものが物語の舞台(メディア)となる時代なのです。
もうちょっと、終わり方考える。。。立体音響を扱う映像クリエイター、プロデューサーに向けての助言的な
空間コンピューティングにおける完全な現実・仮想音響の融合とは、チャンネル数や再生フォーマットの壁(レガシーな2D思考)を完全に消失させることを意味します。未来のクリエイターが記述するのは、もはや『映画のタイムライン』ではなく、『世界の物理法則そのもの』です。OpenUSD等の次世代フォーマットを駆使し、オブジェクトの形・色・素材・音響特性を1つのマトリックスとして包括的にデザインすること。これによって初めて、現実の部屋にバーチャルなゴジラが実物大で出現し、その咆哮の音波が自分の部屋の実際の壁で跳ね返って聴こえるという、視覚と聴覚が完全にシンクロした『真のイマーシブ世界』が完成するのです。
立体音響・イマーシブオーディオ 用語集(Glossary)
【A】
- Accommodation(調節 / ちょうせつ) 【第1章】
- 眼のピントを合わせる毛様体筋の運動。3D映像視聴時には画面表面に固定されるため、音響設計においてもこの固定された距離を意識したデプスマッチングが求められます [1-1, 3-3]。
- Acoustic Ray Tracing(レイトレース方式 / 音線シミュレーション) 【第2章】
- 3D空間内で音源から数千〜数万本の「音の線(音線)」を放射し、壁やオブジェクトへの衝突・反射・減衰・回折をリアルタイムに完全計算する超高精度なレンダリング手法 [2-1]。
- Active Shutter Glasses(アクティブシャッター方式) 【第4章】
- 左右の映像をフル解像度で交互に超高速出力する(フレームシーケンシャル)ディスプレイに同期する3Dメガネ方式。プロジェクターやLED立体パネル(Samsung Onyx等)に導入された際、音響側はプロセッサーと同期した動的オブジェクト定位を組み合わせます [4-1, 4-2]。
- Ambisonics(アンビソニックス) 【第3章】
- 全天球(360度)の音環境全体の波面を、ひとつの球体として数理的に丸ごと記録・再現する音響工学の技術。シーンベースオーディオの基盤 [3-1]。
- Area / Volumetric Source(面源・体積源 / めんげん・たいせきげん) 【第2章】
- 単一の点ではなく、特定の広がり(球体や立方体などの3D形状)を持った範囲から放射される音源モデル。滝、雨、激しい炎などに使用されます [2-2]。
【B】
- Binaural Rendering(バイノーラル再生) 【第4章】
- 3次元空間の音声フォーマット(オブジェクト/シーン)に対し、HRTFフィルターをリアルタイムに掛け合わせ、左右2chのヘッドホン・イヤホン環境で立体音響を疑似再現する出力技術 [4-1]。
【C】
- Channel-Based Audio(チャンネルベース) 【第3章】
- 5.1chや7.1chサラウンドのように、あらかじめ特定の物理的なスピーカーの配置位置に対して音声を固定して割り当てる伝統的な記録・再生方式 [3-1]。
- Crosstalk Cancellation / CTC(クロストークキャンセル) 【第4章】
- 物理スピーカーから立体音響を鳴らす際、右スピーカーの音が左耳に入り混じる現象(混信)を、逆位相の音波を同時に射出することで空気中で物理的に相殺・消滅させるアルゴリズム [4-3]。
【D】
- d&b Soundscape(ディーアンドビー・サウンドスケープ) 【第4章】
- ドイツのd&b audiotechnik社が開発した、オブジェクトベースのライブ用立体音響システム。国内では「SGCホール有明」に常設され、客席全体のすべての座席をスイートスポット化する実績を持ちます [4-2]。
- Depth Matching(デプスマッチング) 【第3章】
- 3D立体映像の視差(Parallax)がもたらす視覚的深度(奥行き)と、立体音響の距離減衰や初期反射がもたらす聴覚的深度を対応させ、空間の認知矛盾を解消する設計思想 [3-3]。
- Distance Attenuation(距離減衰 / きょりげんすい) 【第2章】
- 音源から離れるほど音量が小さくなる物理現象をデジタル空間で再現するパラメータ。対数、線形、カスタムなどの減衰カーブ(ロールオフ)を使い分けます [2-2]。
- Dolby Atmos(ドルビーアトモス) 【第3章・第4章】
- 映画、音楽ストリーミング、ゲームまでを網羅する世界標準のオブジェクトベース音響規格。最大128chのトラックを扱い、10chのベッドと118chの動的オブジェクトで空間を記述します [3-1, 4-1]。
【F】
- Foveated Rendering(フォービエート・レンダリング) 【第4章】
- HMDにおいて、アイトラッキングで検出したユーザーの視線の中心部だけを高解像度で描き、周辺視野の負荷を落とす技術。Apple Immersive Videoなどの立体シアター配信インフラの最適化にも応用されています [4-2]。
【H】
- Head-Tracking(ヘッドトラッキング) 【第1章・第4章】
- HMDやイヤホン内のジャイロセンサーを用い、ユーザーの頭部の回転角を検出する技術。視線移動に合わせて音の空間全体をリアルタイムに逆回転させ、現実空間の「その場」に音をピン留めします [1-3, 4-1]。
- HRTF / Head-Related Transfer Function(頭部伝達関数) 【第1章】
- 音が頭部、顔面、耳介(耳たぶ)を通過して鼓膜に到達するまでの音響的な変化を数理モデル化したもの。2chのイヤホンで3次元の音(上・下・前・後)をピンポイント認知させるための鍵となります [1-1, 1-2]。
- Hybrid Mixing(ハイブリッド・ミキシング) 【第3章】
- 背景全体の環境音を「シーンベース(アンビソニックス)」、特定の移動するキャラクターや効果音を「オブジェクトベース」としてタイムライン上で高度に重ね合わせる現代の標準的ミキシング論 [3-2]。
【I】
- ILD / Interaural Level Difference(両耳間レベル差) 【第1章】
- 音源が左右にずれた際、自分の頭部という障害物によって遮られることで生じる「左右の耳に届く音量差」。主に高音域の角度認識の手がかりとなります [1-1]。
- ITD / Interaural Time Difference(両耳間時間差) 【第1章】
- 音源が左右にずれた際、頭の物理的な幅の分だけ生じる「左右の耳への到達時間差」。約0.0006秒の超微細なディレイであり、主に低音域の左右識別を司ります [1-1]。
【M】
- Motion-to-Sound Latency(モーション・トゥ・サウンド遅延) 【第1章・第4章】
- 頭が動いてから、ヘッドトラッキングによって音が補正されるまでに生じる遅延時間。3D酔いや空間の不快感を防ぐため、20ミリ秒(ms)以内への制御が絶対条件となります [1-3, 4-1]。
- MV-HEVC(マルチビュービデオコーディング) 【第4章】
- Apple Vision Proなどが採用する高効率な立体映像フォーマット。左目用映像に対する「右目の視差(Disparity)の差分データ」のみを記録するため、空間オーディオを内包した3D動画の配信サイズを劇的に軽量化できます [4-2]。
【O】
- Object-Based Audio(オブジェクトベース) 【第3章】
- 音声波形に「空間上の3次元座標(X, Y, Z)」のメタデータを付与し、独立した移動オブジェクトとして管理する方式。再生環境(スピーカー数やイヤホン)に合わせてリアルタイムにローカルレンダリングされます [3-1]。
- OpenUSD / Universal Scene Description(オープン・ユーエスディー) 【第5章】
- 3D空間全体の構造を記述する次世代の標準シーン記述フォーマット。3Dオブジェクトの形状やテクスチャのデータに、木材やコンクリートといった「音響物理特性のメタデータ(吸音率・反射率)」を完全統合できます [5-2]。
【P】
- Point Source(点源 / てんげん) 【第2章】
- 空間内の特定の1点(X, Y, Zの単一座標)から全方位に向かって球面波として放射される最小の音源モデル。キャラクターのセリフや足音、ピンポイントなUI音などに適しています [2-2]。
- Predictive Rendering(特徴予測方式) 【第2章】
- あらかじめ空間(部屋)の広さや形状などの静的なデータをベースに、発生する残響の減衰特性を事前に計算・マッピングしておく低負荷な立体音響レンダリング手法 [2-1]。
【S】
- Size / Spread(サイズ / 拡散率) 【第3章】
- オブジェクトベース音響において、音の3次元座標を中心に、周囲の空間やアンビエンス側へどれだけ音を滑らかに滲ませる(広げる)かを制御する動的パラメータ [3-2]。
- SOFA / Spatially Oriented Format for Acoustics(ソーファ規格) 【第1章】
- 個人のHRTFデータを記述するために標準化されたオープンなデータ記述フォーマット。
スマホ等の耳スキャンからユーザー専用のオーダーメイドHRTFを動的ロードするインフラとして機能します[1-2]。
- 個人のHRTFデータを記述するために標準化されたオープンなデータ記述フォーマット。
- Sound xR Image(サウンド・エックスアール・イメージ) 【第4章】
- 日本のヤマハ(YAMAHA)株式会社が開発した、中小規模のライブハウスやイベント展示スペース向け立体音響ソリューション。立体音響インフラの低コスト化と民主化を牽引しています [4-2]。
【T】
- 360 Reality Audio(サンロクマル・リアリティオーディオ) 【第3章・第4章】
- ソニーが提唱する、音楽・ライブ体験に特化したオブジェクトベース規格。リスナーを中心とした完全な「全天球(球体空間)」として最大64個のオブジェクトをマッピング記述します [3-1, 4-1]。
- Transaural Audio(トランスオーラル再生) 【第4章】
- イヤホンやヘッドホンを一切着用しない(生耳の)状態のリスナーに対し、目の前にある少数の物理スピーカーからクロストークキャンセル技術を用いて「真横や真後ろ」にピンポイントな空間オーディオを届ける技術 [4-3]。
【V】
- Virtual Voicing(仮想ボイス機能) 【第2章】
- 最大同時発音数の限界を超えた際、優先度の低い遠景の音の音声デコードやDSP計算を物理的に停止し、無音のまま座標計算(データ追従)だけを維持するインテリジェントなシステム負荷管理セーフティ [2-3]。
- Volumetric Audio(ボリュメトリックオーディオ) 【第5章】
- 従来の無限に小さな「1点(点源)」としての配置を超え、3Dキャプチャされた実写オブジェクト(ボリュメトリックビデオ)などの「形状の表面全体」から、物理的に整合性のある立体的な音波を発生・再現する次世代技術 [5-1]。
立体音響パート 参考文献(References)
【学術・国際規格(Standards & Academic Papers)】
- AES69-2015 (r2020):
- AES standard for file format to store spatial acoustic data – Spatially Oriented Format for Acoustics (SOFA). Audio Engineering Society.
- (第1章1-2:個人最適化HRTFの共通記述フォーマットに関する国際標準規格)
- ISO/IEC 23008-3 (MPEG-H Part 3):
- Information technology — High efficiency coding and media delivery in heterogeneous environments — Part 3: 3D audio.
- (第3章3-1、第4章4-1:360 Reality Audioのベースとなる天球オブジェクト音響フォーマットの国際規格)
- ISO 9613-1:1993:
- Acoustics — Attenuation of sound during propagation outdoors — Part 1: Calculation of the absorption of sound by the atmosphere.
- (第2章2-2:空気吸収および動的ローパスフィルター計算の物理的数理モデルの基準)
【業界ガイドライン・技術ドキュメント(Industry Guidelines & Tech Docs)】
- Dolby Laboratories:
- Dolby Atmos Professional Mixing and Mastering Guidelines.
- (第3章3-1, 3-2:ベッドトラックと音声オブジェクトのハイブリッド・ミキシングに関する公式仕様書)
- Apple Inc.:
- Spatial Audio Application Programming Interface (API) and Developer Documentation for visionOS. Apple Developer Documentation.
- (第4章4-1, 第5章5-2:Apple Vision Proにおけるオーディオ・レイトレーシングおよび空間ピン留めの実装仕様)
【実空間・LBE導入実績(LBE & Live Stage Case Studies)】
- ヒビノ株式会社 (Hibino Corporation):
- 「YOASOBI ZEPP TOUR 2024 “POP OUT” におけるイマーシブLEDシステム(Ghost Tile)および立体音響の統合運用について」, プレスリリース/技術レポート(2024年3月).
- (第4章4-2:アジア初の大規模イマーシブ・ライブステージ実績の記録)
- ヤマハ株式会社 (YAMAHA Corporation):
- 「中小規模ライブパフォーマンスのための立体音響ソリューション『Sound xR Image』の実証実験開始に関するロードマップ」, ヤマハ・ニュースリリース.
- (第4章4-2:立体音響の民主化とアミューズメント施設での検証データ)
- d&b audiotechnik GmbH:
- d&b Soundscape DS100 Signal Engine: Architectural Integration and Wave Field Synthesis Application Note.
- (第4章4-2:東京・有明「SGCホール有明」に常設されたオブジェクトベース音響システムの設計書)
【日本語の専門書(理論・基礎)】
『立体音響(音響学講座 6)』著者: 飯田 一博(著)出版社: コロナ社
内容・価値: 日本の音響学における、立体音響のバイブル的教科書です。第1章で解説したILD(両耳間レベル差)やITD(両耳間時間差)、HRTF(頭部伝達関数)の数理モデル、バイノーラル再生の仕組みが、物理的・生理音響学的な視点から極めて厳密に解説されています。大学の研究室や開発者が数理アルゴリズムを実装する際の絶対的なリファレンスです。
【日本語の実務書(制作・ゲーム実装)】
『空間音響学』著者: ジェンス・ブラウエルト(著)、森本 政之(訳)出版社: 鹿島出版会
内容・価値: 世界的な空間音響の権威であるブラウエルト教授の歴史的名著『Spatial Hearing』の日本語翻訳版です。人間がどのように音の「上下」「前後」「距離」を認知しているのかという生体知覚トリックの本質が、膨大な実験データとともにまとめられており、立体音響の「基礎理論」を固める上で外せない一冊です。

『ゲームサウンド制作ガイド(ゲームオーディオの職人技、理論、および実務)』
著者: リチャード・スティーブンス、デイブ・レイボールド(著)出版社: ボーンデジタル
内容・価値: 主要な3Dゲームエンジン(Unity/Unreal Engine)内での音響設計に特化した実践書です。第2章で扱った「特徴予測とレイトレース音響の使い分け」や「オーディオ・バジェット(負荷制限)の設計」「距離減衰のカーブ設計」といった実装の実務が、現場のクリエイター向けに分かりやすく記述されています。
『サラウンド入門』
沢口 真生 (著) 形式: 単行本
本書は、映画、DVD、デジタル放送などにおける新しい音響フォーマットとして採用されている「サラウンド制作」について書かれた実践的な解説書です。サラウンドのサウンドデザイン(沢口)、サラウンドスタジオの音響設計(中原)、そしてサラウンドの収音手法(亀川)といったサラウンドに関する様々なノウハウを、それぞれの専門分野で活躍している3人の著者がわかりやすく解説しています。
3D Audio (Perspectives on Music Production)
3D Audio offers a detailed perspective of this rapidly developing arena. Written by many of the world’s leading researchers and practitioners, it draws from science, technologies, and creative practice to provide insight into cutting-edge research in 3D audio.

『Spatial Audio (Audio Engineering Society Presents)』
著者: Francis Rumsey(著)出版社: Routledge
内容・価値: オーディオ工学の世界的権威であるAES(国際音響学会)が編纂した、立体音響の包括的な技術書です。SOFA規格の背景にある個人用HRTFの測定技術から、空間記述フォーマットの未来にいたるまで、技術者・システム開発者が知るべき高度なトピックが美しくまとめられています。

『Sonic Spaces: Principles and Practices of Spatial Audio』
著者: Jason Corey(著)出版社: Focal Press
内容・価値: 現代のイマーシブ・ポストプロ現場の標準書です。Dolby Atmosやアンビソニックス(シーンベース)を用いたハイブリッド・ミキシングの基本設計、スピーカーアレイとヘッドホンのデコードの違いなど、現代の配信プラットフォームに直結するワークフローが網羅されています。
〈了〉
ⓒ2026 Immersive Content Society